# Data manipulation and analysis
import pandas as pd
import time
import numpy as np
pd.set_option('display.max_columns', None)  # Show all columns
# Suppress warnings
import warnings
warnings.filterwarnings('ignore')

from scipy import stats

# Visualization
import seaborn as sns
import matplotlib.pyplot as plt

# Machine Learning Libraries
import xgboost as xgb
# from tensorflow import keras  # Neural Network

# Sample more heavily from the edge fraud cases
# from sklearn.utils import resample

# from sklearn.preprocessing import OneHotEncoder

# from sklearn.ensemble import GradientBoostingClassifier

from sklearn.linear_model import LogisticRegression
import lightgbm as lgb
from sklearn.tree import DecisionTreeClassifier
from imblearn.under_sampling import RandomUnderSampler
# Metrics for model evaluation
from sklearn.metrics import classification_report, confusion_matrix, roc_auc_score, precision_recall_curve, accuracy_score, f1_score, auc, roc_curve, precision_score, recall_score, average_precision_score
# Data preprocessing
from sklearn.preprocessing import StandardScaler, RobustScaler  # Feature scaling
from sklearn.preprocessing import LabelEncoder    # Categorical encoding
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier, VotingClassifier
from catboost import CatBoostClassifier
from sklearn.neighbors import KNeighborsClassifier
# Load the dataset
# Assuming your dataset is in CSV format and in the same directory as the notebook
df = pd.read_csv('PS_20174392719_1491204439457_log.csv')All research / Fraud detection
The notebook
online-payment-fraud-detection-v7.ipynb: 84 cells (82 of code), 30 charts, Python 3.12.0
# Display basic information about the dataset
print("Dataset Info:")
print("-" * 50)
df.info()
Out
Dataset Info:
--------------------------------------------------
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 6362620 entries, 0 to 6362619
Data columns (total 11 columns):
 #   Column          Dtype
---  ------          -----
 0   step            int64
 1   type            object
 2   amount          float64
 3   nameOrig        object
 4   oldbalanceOrg   float64
 5   newbalanceOrig  float64
 6   nameDest        object
 7   oldbalanceDest  float64
 8   newbalanceDest  float64
 9   isFraud         int64
 10  isFlaggedFraud  int64
dtypes: float64(5), int64(3), object(3)
memory usage: 534.0+ MB
print("\nFirst few rows of the dataset:")
print("-" * 50)
display(df.head())
Out
First few rows of the dataset:
--------------------------------------------------
   step      type    amount     nameOrig  oldbalanceOrg  newbalanceOrig  \
0     1   PAYMENT   9839.64  C1231006815       170136.0       160296.36
1     1   PAYMENT   1864.28  C1666544295        21249.0        19384.72
2     1  TRANSFER    181.00  C1305486145          181.0            0.00
3     1  CASH_OUT    181.00   C840083671          181.0            0.00
4     1   PAYMENT  11668.14  C2048537720        41554.0        29885.86

      nameDest  oldbalanceDest  newbalanceDest  isFraud  isFlaggedFraud
0  M1979787155             0.0             0.0        0               0
1  M2044282225             0.0             0.0        0               0
2   C553264065             0.0             0.0        1               0
3    C38997010         21182.0             0.0        1               0
4 M1230701703 0.0 0.0 0 0 print("\nBasic statistics of numerical columns:")
print("-" * 50)
display(df.describe())Out
Basic statistics of numerical columns:
--------------------------------------------------
               step        amount  oldbalanceOrg  newbalanceOrig  \
count  6.362620e+06  6.362620e+06   6.362620e+06    6.362620e+06
mean   2.433972e+02  1.798619e+05   8.338831e+05    8.551137e+05
std    1.423320e+02  6.038582e+05   2.888243e+06    2.924049e+06
min    1.000000e+00  0.000000e+00   0.000000e+00    0.000000e+00
25%    1.560000e+02  1.338957e+04   0.000000e+00    0.000000e+00
50%    2.390000e+02  7.487194e+04   1.420800e+04    0.000000e+00
75%    3.350000e+02  2.087215e+05   1.073152e+05    1.442584e+05
max    7.430000e+02  9.244552e+07   5.958504e+07    4.958504e+07

       oldbalanceDest  newbalanceDest       isFraud  isFlaggedFraud
count    6.362620e+06    6.362620e+06  6.362620e+06    6.362620e+06
mean     1.100702e+06    1.224996e+06  1.290820e-03    2.514687e-06
std      3.399180e+06    3.674129e+06  3.590480e-02    1.585775e-03
min      0.000000e+00    0.000000e+00  0.000000e+00    0.000000e+00
25%      0.000000e+00    0.000000e+00  0.000000e+00    0.000000e+00
50%      1.327057e+05    2.146614e+05  0.000000e+00    0.000000e+00
75%      9.430367e+05    1.111909e+06  0.000000e+00    0.000000e+00
max 3.560159e+08 3.561793e+08 1.000000e+00 1.000000e+00 #EDA
# Check class imbalance for fraud detection
df['isFraud'].value_counts()Out
isFraud
0    6354407
1       8213
Name: count, dtype: int64
# Get the value counts
fraud_counts = df['isFraud'].value_counts()

# Define labels and colors
labels = ['Non-Fraud (0)', 'Fraud (1)']
colors = ['skyblue', 'salmon']

# Create the pie chart
plt.figure(figsize=(8, 8))
plt.pie(fraud_counts.values, labels=labels, colors=colors,
        autopct=lambda p: f'{p:.2f}%\n({int(p * sum(fraud_counts.values) / 100):,})',
        startangle=90, textprops={'fontsize': 12, 'weight': 'bold'})

# Add title
plt.title('Class Distribution: Fraud vs. Non-Fraud', fontsize=16)

plt.tight_layout()
plt.show()
Out
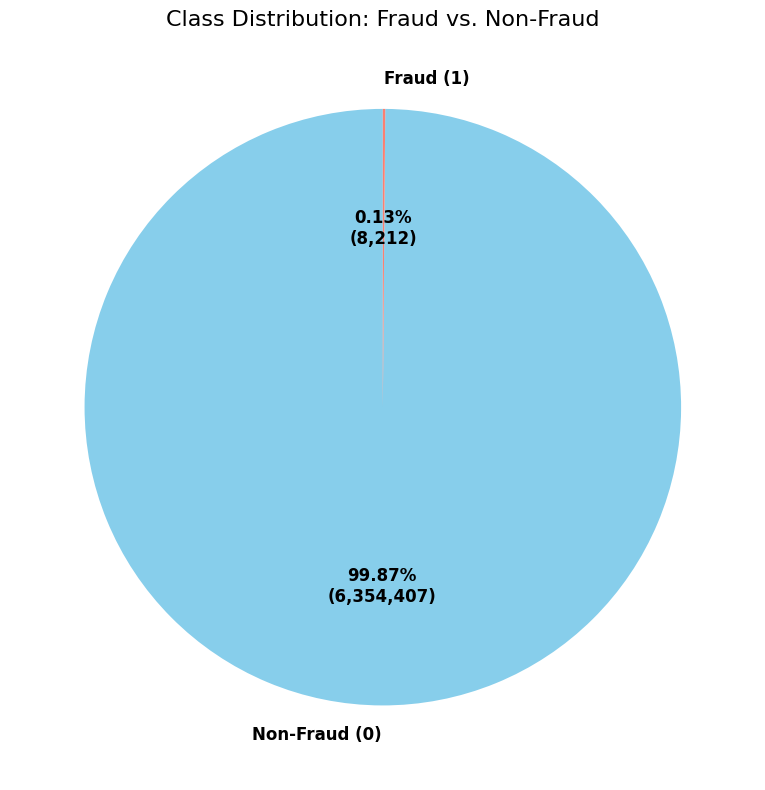
print("\nFraud Distribution:")
print(df['isFraud'].value_counts(normalize=True) * 100)
print("\nFlagged Fraud Distribution:")
print(df['isFlaggedFraud'].value_counts(normalize=True) * 100)
Out
Fraud Distribution:
isFraud
0    99.870918
1     0.129082
Name: proportion, dtype: float64

Flagged Fraud Distribution:
isFlaggedFraud
0    99.999749
1     0.000251
Name: proportion, dtype: float64
# TRANSACTION TYPE ANALYSIS
print("\nTransaction Types:")
print(df['type'].value_counts())
Out
Transaction Types:
type
CASH_OUT    2237500
PAYMENT     2151495
CASH_IN     1399284
TRANSFER     532909
DEBIT         41432
Name: count, dtype: int64
# 1. Transaction Type and Fraud
plt.figure(figsize=(12, 5))
sns.countplot(x='type', hue='isFraud', data=df)
plt.title('Transaction Types and Fraud')
plt.yscale('log')  # Log scale because of class imbalance
plt.legend(['Legitimate', 'Fraud'])
plt.tight_layout()
plt.savefig('transaction_type_fraud.png')
plt.show()
# 1. Check fraud distribution by transaction type
fraud_by_type = df.groupby('type')['isFraud'].mean() * 100
print("\nFraud Percentage by Transaction Type:")
print(fraud_by_type)
Out
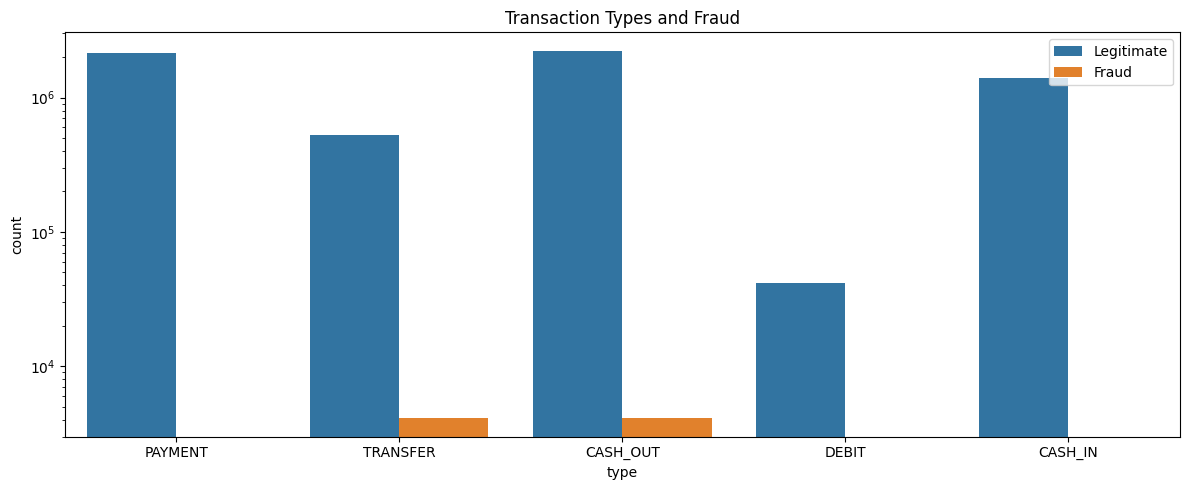
Fraud Percentage by Transaction Type:
type
CASH_IN     0.000000
CASH_OUT    0.183955
DEBIT       0.000000
PAYMENT     0.000000
TRANSFER    0.768799
Name: isFraud, dtype: float64
# analysing fraud through transaction type
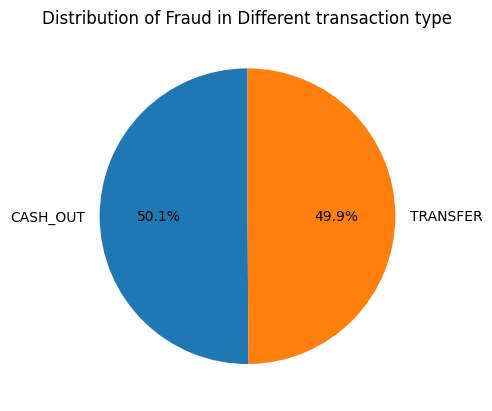
fraud_df=df[df['isFraud']==1].groupby('type')['isFraud'].sum().reset_index()
fraud_df
Out
       type  isFraud
0  CASH_OUT     4116
1  TRANSFER     4097
plt.pie(fraud_df['isFraud'],labels=fraud_df['type'], autopct='%1.1f%%', startangle=90)
plt.title('Distribution of Fraud in Different transaction type')
plt.show()
Out
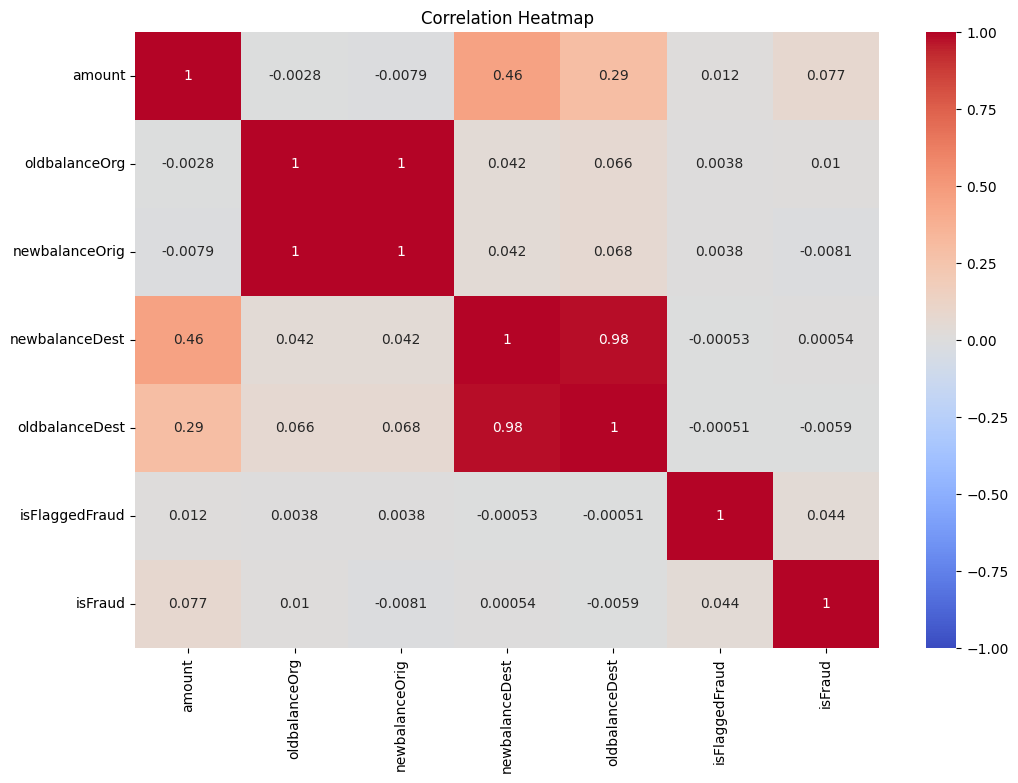
num_cols=['amount','oldbalanceOrg','newbalanceOrig','newbalanceDest','oldbalanceDest','isFlaggedFraud','isFraud']
corr_matrix=df[num_cols].corr()
plt.figure(figsize=(12, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', vmin=-1, vmax=1)
plt.title('Correlation Heatmap')
plt.show()
Out
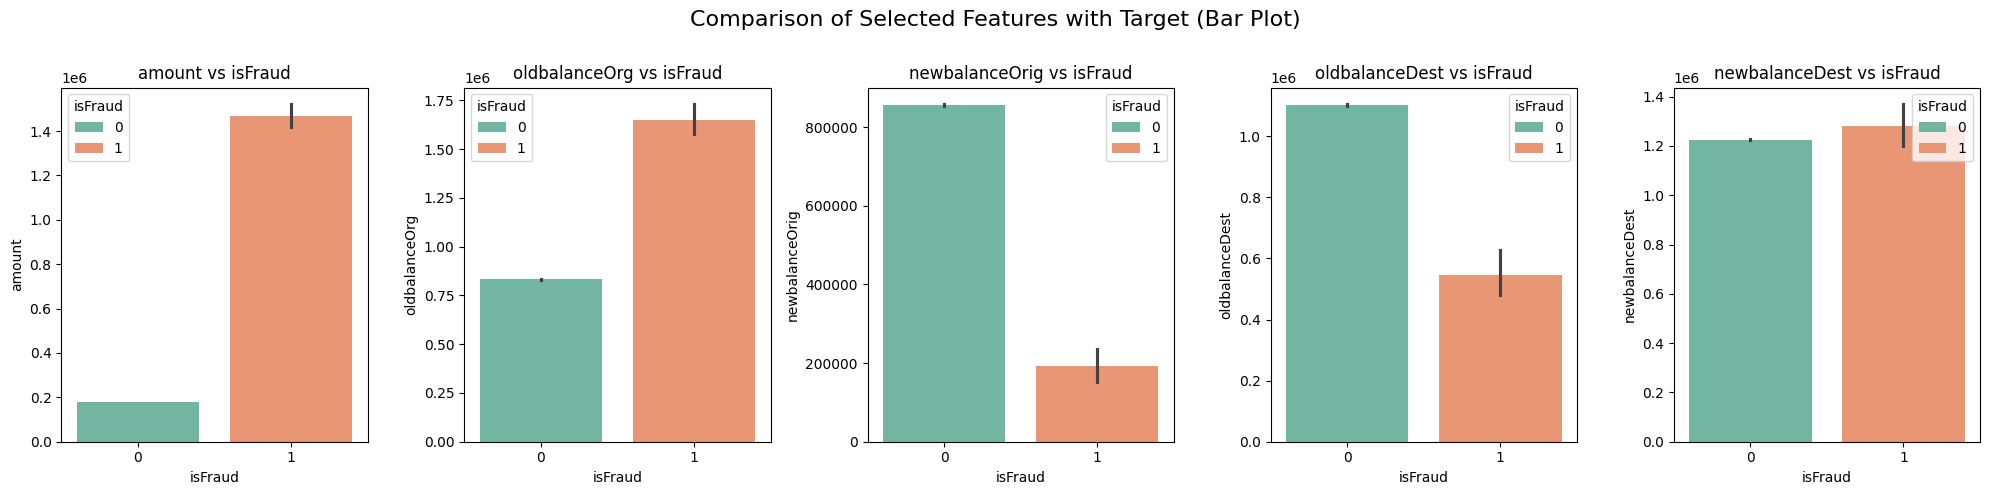
# List of selected features to analyze
selected_features = ['amount', 'oldbalanceOrg', 'newbalanceOrig', 'oldbalanceDest', 'newbalanceDest']

# Create subplots (number of subplots is equal to the number of selected features)
fig, axes = plt.subplots(1, len(selected_features), figsize=(20, 5))

# Loop through each selected feature to create individual bar plots
for i, feature in enumerate(selected_features):
    sns.barplot(x=df['isFraud'], y=df[feature], hue=df['isFraud'], ax=axes[i], palette="Set2")
    axes[i].set_title(f'{feature} vs isFraud')  # Title for each subplot
    axes[i].set_xlabel('isFraud')
    axes[i].set_ylabel(feature)

# Add a title for the overall figure and adjust layout for better spacing
plt.suptitle("Comparison of Selected Features with Target (Bar Plot)", fontsize=16)
plt.tight_layout()
plt.show()
Out
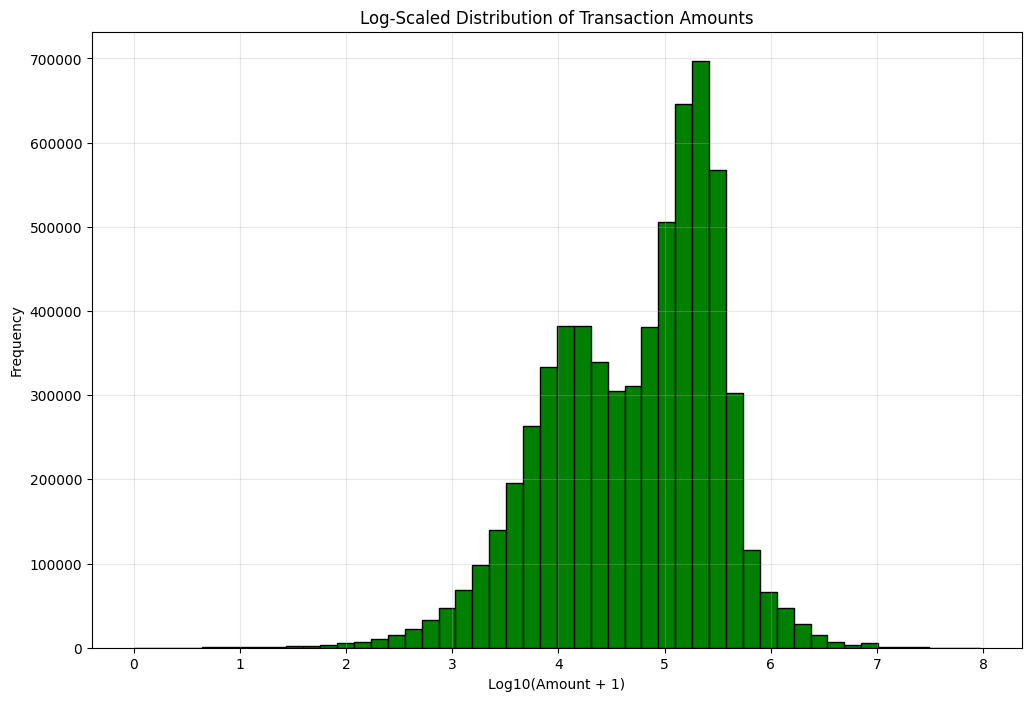
plt.figure(figsize=(12, 8))
# Add a small value to handle zeros
non_zero_amounts = df['amount'][df['amount'] > 0]
plt.hist(np.log10(non_zero_amounts + 1), bins=50, color='green', edgecolor='black')
plt.title('Log-Scaled Distribution of Transaction Amounts')
plt.xlabel('Log10(Amount + 1)')
plt.ylabel('Frequency')
plt.grid(True, alpha=0.3)
Out
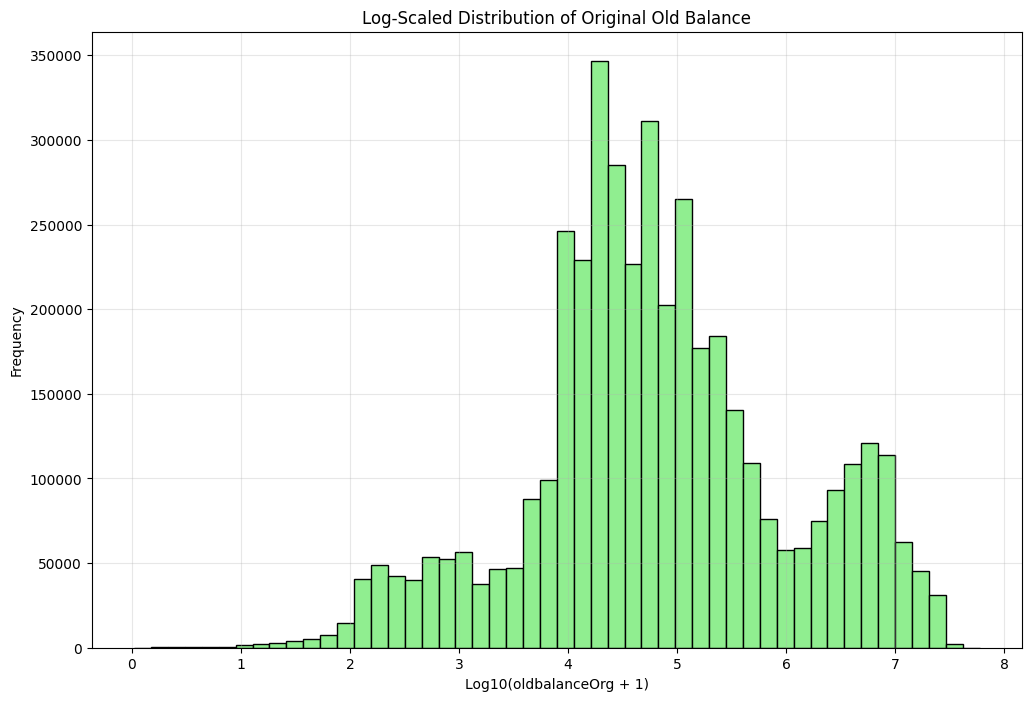
# Create log-scaled histogram for oldbalanceOrg
plt.figure(figsize=(12, 8))
# Add a small value to handle zeros
non_zero_oldbalance = df['oldbalanceOrg'][df['oldbalanceOrg'] > 0]
plt.hist(np.log10(non_zero_oldbalance + 1), bins=50, color='lightgreen', edgecolor='black')
plt.title('Log-Scaled Distribution of Original Old Balance')
plt.xlabel('Log10(oldbalanceOrg + 1)')
plt.ylabel('Frequency')
plt.grid(True, alpha=0.3)
Out
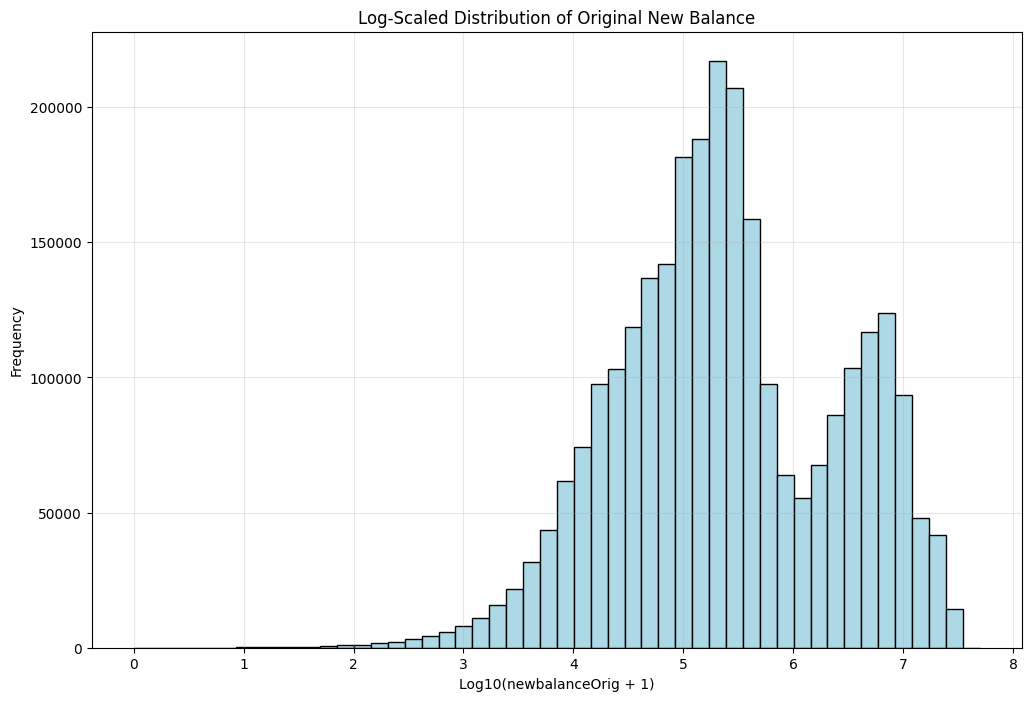
# Create log-scaled histogram for newbalanceOrig
plt.figure(figsize=(12, 8))
non_zero_newbalanceOrig = df['newbalanceOrig'][df['newbalanceOrig'] > 0]
plt.hist(np.log10(non_zero_newbalanceOrig + 1), bins=50, color='lightblue', edgecolor='black')
plt.title('Log-Scaled Distribution of Original New Balance')
plt.xlabel('Log10(newbalanceOrig + 1)')
plt.ylabel('Frequency')
plt.grid(True, alpha=0.3)
Out
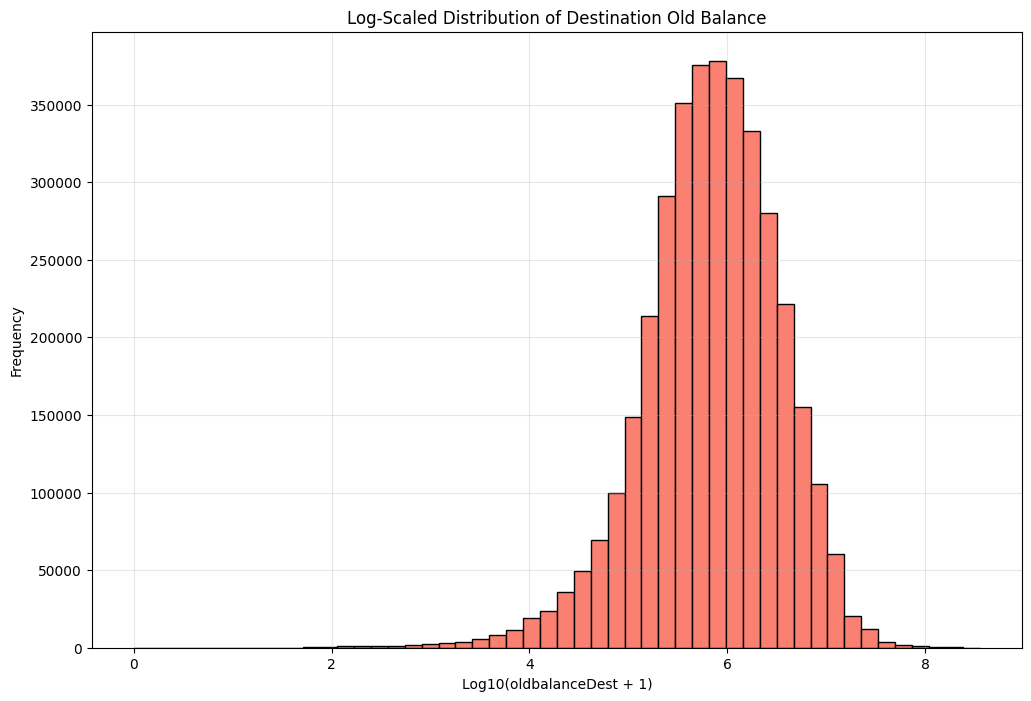
# Create log-scaled histogram for oldbalanceDest
plt.figure(figsize=(12, 8))
non_zero_oldbalanceDest = df['oldbalanceDest'][df['oldbalanceDest'] > 0]
plt.hist(np.log10(non_zero_oldbalanceDest + 1), bins=50, color='salmon', edgecolor='black')
plt.title('Log-Scaled Distribution of Destination Old Balance')
plt.xlabel('Log10(oldbalanceDest + 1)')
plt.ylabel('Frequency')
plt.grid(True, alpha=0.3)
Out
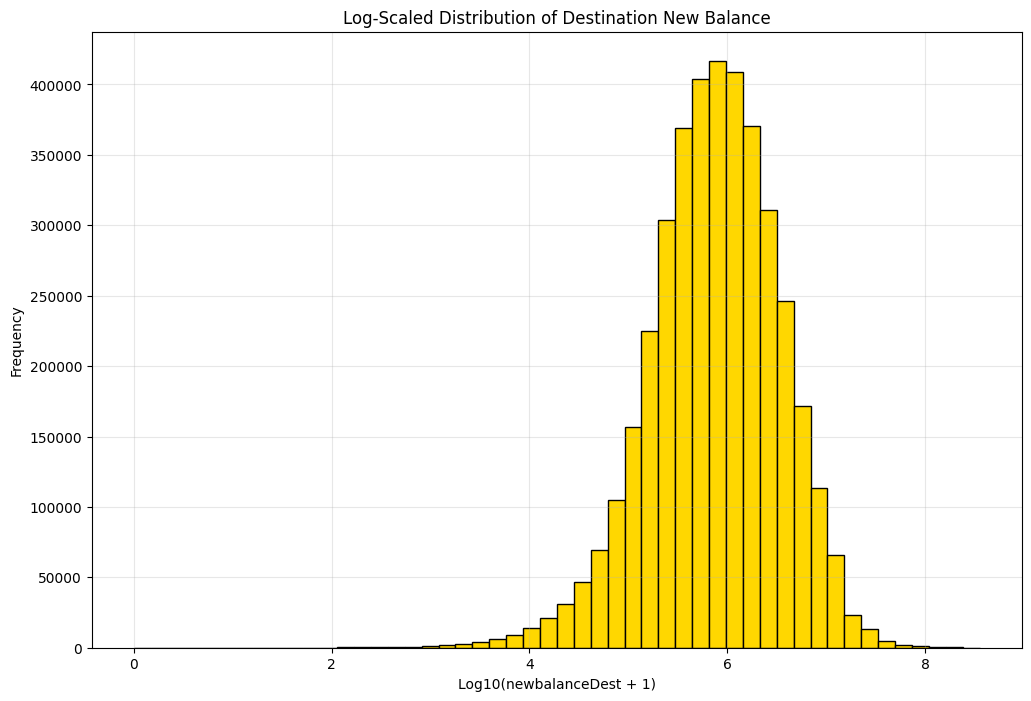
# Create log-scaled histogram for newbalanceDest
plt.figure(figsize=(12, 8))
non_zero_newbalanceDest = df['newbalanceDest'][df['newbalanceDest'] > 0]
plt.hist(np.log10(non_zero_newbalanceDest + 1), bins=50, color='gold', edgecolor='black')
plt.title('Log-Scaled Distribution of Destination New Balance')
plt.xlabel('Log10(newbalanceDest + 1)')
plt.ylabel('Frequency')
plt.grid(True, alpha=0.3)
Out
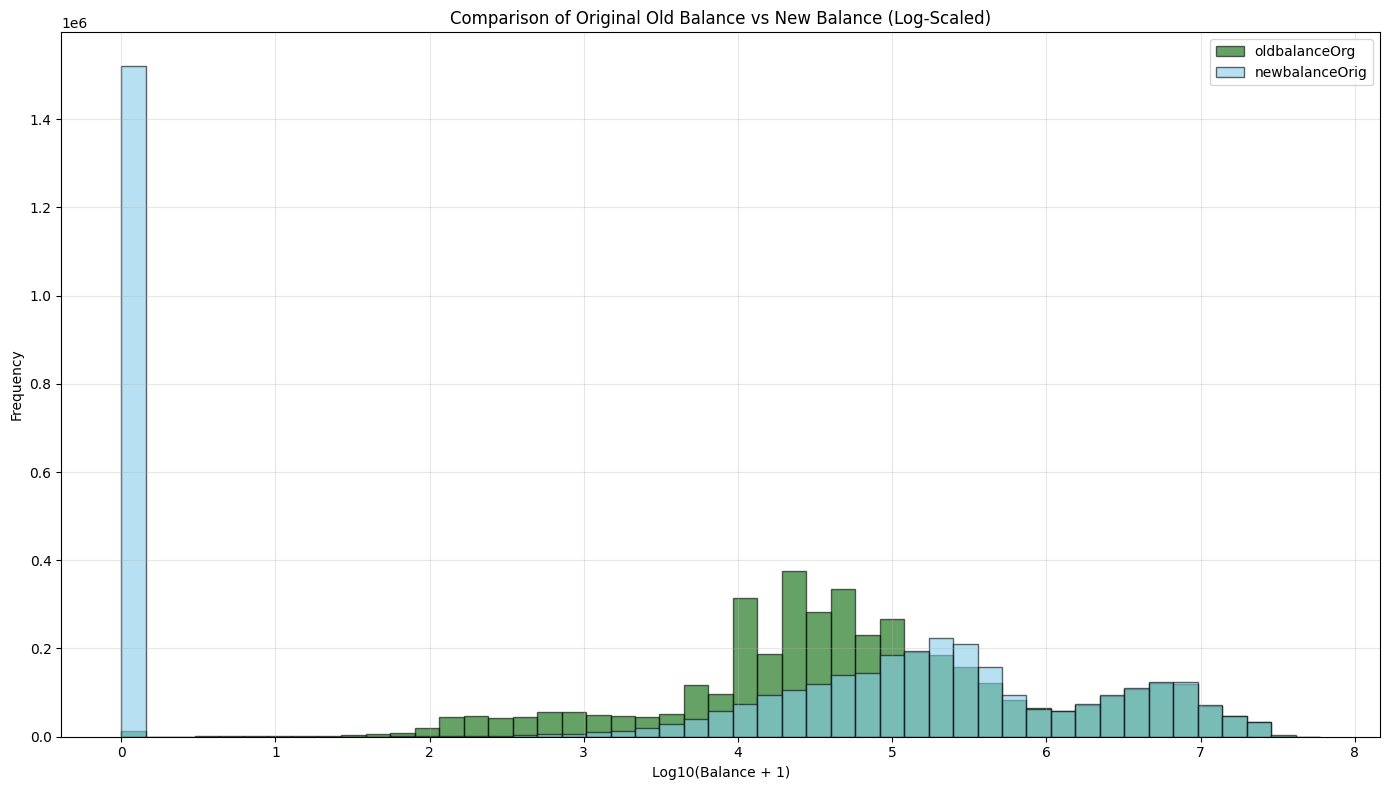
# Create comparison histogram for oldbalanceOrg vs newbalanceOrig
plt.figure(figsize=(14, 8))

# Filter out zero values
non_zero_df = df[(df['oldbalanceOrg'] > 0) | (df['newbalanceOrig'] > 0)]

# Create log transformed values for better visualization
log_old = np.log10(non_zero_df['oldbalanceOrg'] + 1)
log_new = np.log10(non_zero_df['newbalanceOrig'] + 1)

# Calculate bin edges for both histograms to share
min_val = min(log_old.min(), log_new.min())
max_val = max(log_old.max(), log_new.max())
bins = np.linspace(min_val, max_val, 50)

# Plot both histograms on same axes
plt.hist(log_old, bins=bins, alpha=0.6, label='oldbalanceOrg', color='darkgreen', edgecolor='black')
plt.hist(log_new, bins=bins, alpha=0.6, label='newbalanceOrig', color='skyblue', edgecolor='black')

plt.title('Comparison of Original Old Balance vs New Balance (Log-Scaled)')
plt.xlabel('Log10(Balance + 1)')
plt.ylabel('Frequency')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
Out
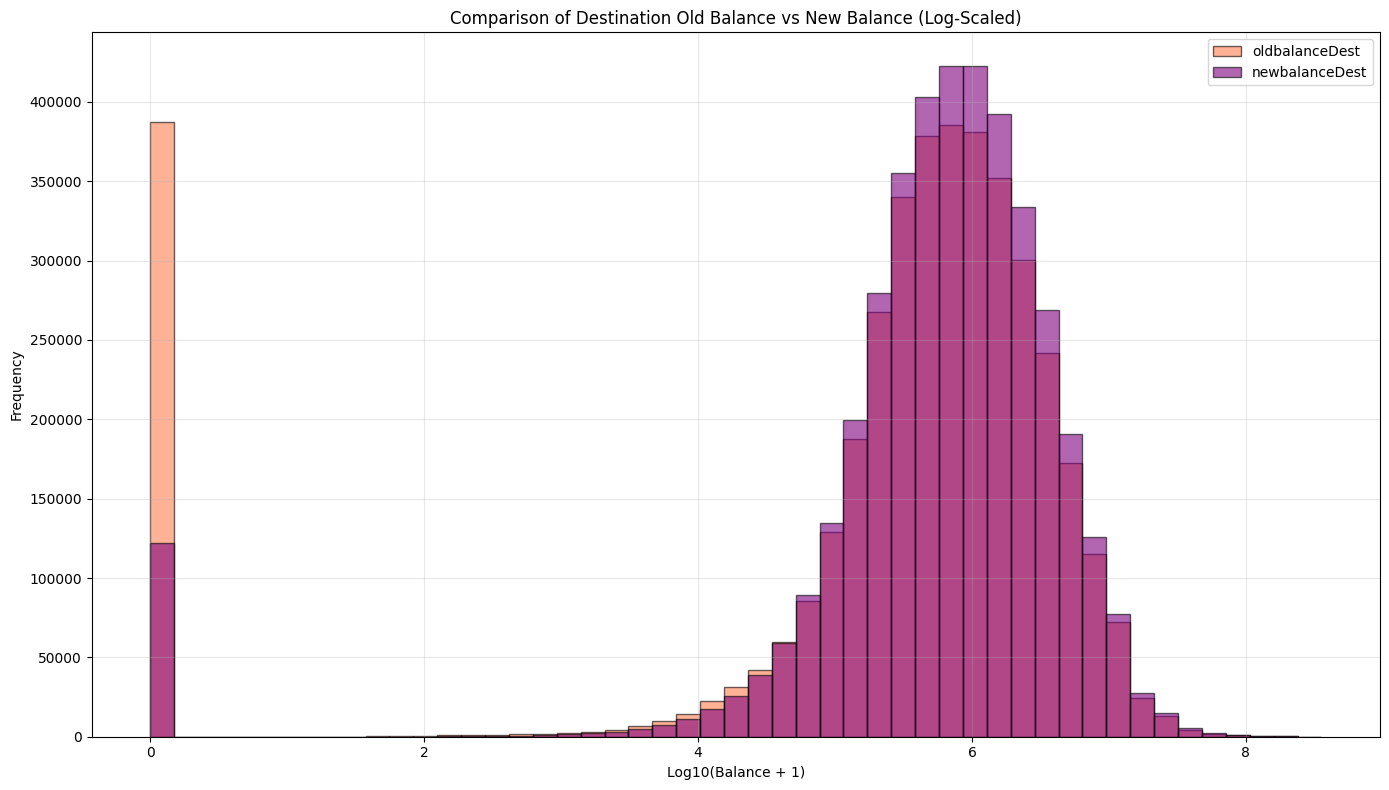
# Create comparison histogram for oldbalanceDest vs newbalanceDest
plt.figure(figsize=(14, 8))

# Filter out zero values
non_zero_dest_df = df[(df['oldbalanceDest'] > 0) | (df['newbalanceDest'] > 0)]

# Create log transformed values for better visualization
log_old_dest = np.log10(non_zero_dest_df['oldbalanceDest'] + 1)
log_new_dest = np.log10(non_zero_dest_df['newbalanceDest'] + 1)

# Calculate bin edges for both histograms to share
min_val_dest = min(log_old_dest.min(), log_new_dest.min())
max_val_dest = max(log_old_dest.max(), log_new_dest.max())
bins_dest = np.linspace(min_val_dest, max_val_dest, 50)

# Plot both histograms on same axes
plt.hist(log_old_dest, bins=bins_dest, alpha=0.6, label='oldbalanceDest', color='coral', edgecolor='black')
plt.hist(log_new_dest, bins=bins_dest, alpha=0.6, label='newbalanceDest', color='purple', edgecolor='black')

plt.title('Comparison of Destination Old Balance vs New Balance (Log-Scaled)')
plt.xlabel('Log10(Balance + 1)')
plt.ylabel('Frequency')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
Out
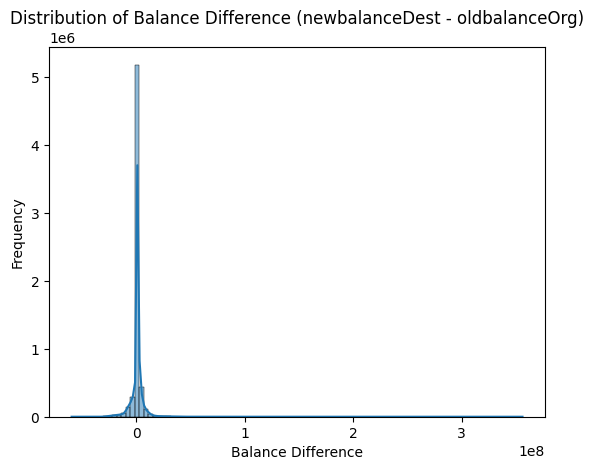
df['balance_diff'] = df['newbalanceDest'] - df['oldbalanceOrg']
sns.histplot(df['balance_diff'], bins=100, kde=True)
plt.title('Distribution of Balance Difference (newbalanceDest - oldbalanceOrg)')
plt.xlabel('Balance Difference')
plt.ylabel('Frequency')
plt.show()
Out
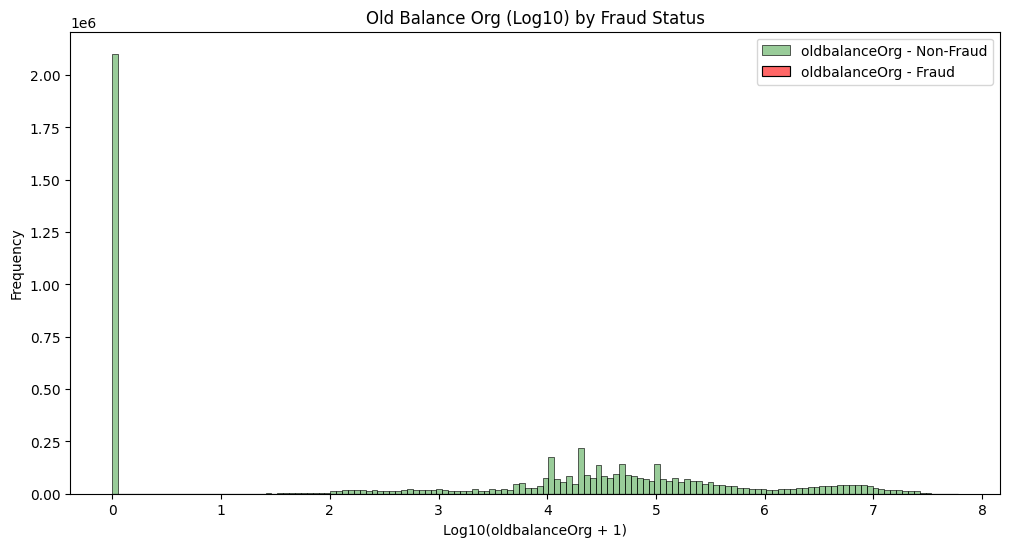
df['log_old_org'] = np.log10(df['oldbalanceOrg'] + 1)
df['log_new_dest'] = np.log10(df['newbalanceDest'] + 1)

plt.figure(figsize=(12, 6))
sns.histplot(data=df[df['isFraud'] == 0], x='log_old_org', color='green', label='oldbalanceOrg - Non-Fraud', alpha=0.4)
sns.histplot(data=df[df['isFraud'] == 1], x='log_old_org', color='red', label='oldbalanceOrg - Fraud', alpha=0.6)
plt.legend()
plt.title('Old Balance Org (Log10) by Fraud Status')
plt.xlabel('Log10(oldbalanceOrg + 1)')
plt.ylabel('Frequency')
plt.show()
Out
# Handle missing values
print("Missing values before handling:")
print(df.isnull().sum())
Out
Missing values before handling:
step              0
type              0
amount            0
nameOrig          0
oldbalanceOrg     0
newbalanceOrig    0
nameDest          0
oldbalanceDest    0
newbalanceDest    0
isFraud           0
isFlaggedFraud    0
dtype: int64
# Check for zero values in important numeric columns
numeric_cols = ['amount', 'oldbalanceOrg', 'newbalanceOrig', 'oldbalanceDest', 'newbalanceDest']
print('\nZero values in numeric columns:')
zero_counts = {col: (df[col] == 0).sum() for col in numeric_cols}
zero_percentages = {col: (count/len(df)*100).round(2) for col, count in zero_counts.items()}
zero_df = pd.DataFrame({
    'Zero Count': zero_counts,
    'Percentage': zero_percentages
})
print(zero_df)
Out
Zero values in numeric columns:
                Zero Count  Percentage
amount                  16        0.00
oldbalanceOrg      2102449       33.04
newbalanceOrig     3609566       56.73
oldbalanceDest     2704388       42.50
newbalanceDest 2439433 38.34# Create new features
# Flag transactions where all balance is transferred out
df['emptied_account'] = ((df['oldbalanceOrg'] > 0) & (df['newbalanceOrig'] == 0)).astype(int)
# Flag suspicious patterns (like identical amounts)
df['amount_equals_oldbalanceOrg'] = (df['amount'] == df['oldbalanceOrg']).astype(int)df['hour'] = df['step'] % 24 # Extract hour from step (since 1 step = 1 hour)
df['is_night'] = df['hour'].apply(lambda x: 1 if x < 6 else 0) # Flag night transactions
df['amount_ratio'] = df['amount'] / (df['oldbalanceOrg'] + 1)# Create new binary columns for CASH_OUT and TRANSFER transactions
df['is_CASH_OUT'] = (df['type'] == 'CASH_OUT').astype(int)
df['is_TRANSFER'] = (df['type'] == 'TRANSFER').astype(int)
df['is_DEBIT'] = (df['type'] == 'DEBIT').astype(int)
df['is_PAYMENT'] = (df['type'] == 'PAYMENT').astype(int)
# Display the first few rows to verify the new columns
df.head()Out
   step      type    amount     nameOrig  oldbalanceOrg  newbalanceOrig  \
0     1   PAYMENT   9839.64  C1231006815       170136.0       160296.36
1     1   PAYMENT   1864.28  C1666544295        21249.0        19384.72
2     1  TRANSFER    181.00  C1305486145          181.0            0.00
3     1  CASH_OUT    181.00   C840083671          181.0            0.00
4     1   PAYMENT  11668.14  C2048537720        41554.0        29885.86

      nameDest  oldbalanceDest  newbalanceDest  isFraud  isFlaggedFraud  \
0  M1979787155             0.0             0.0        0               0
1  M2044282225             0.0             0.0        0               0
2   C553264065             0.0             0.0        1               0
3    C38997010         21182.0             0.0        1               0
4  M1230701703             0.0             0.0        0               0

   emptied_account  amount_equals_oldbalanceOrg  hour  is_night  amount_ratio  \
0                0                            0     1         1      0.057834
1                0                            0     1         1      0.087731
2                1                            1     1         1      0.994505
3                1                            1     1         1      0.994505
4                0                            0     1         1      0.280788

   is_CASH_OUT  is_TRANSFER  is_DEBIT  is_PAYMENT
0            0            0         0           1
1            0            0         0           1
2            0            1         0           0
3            1            0         0           0
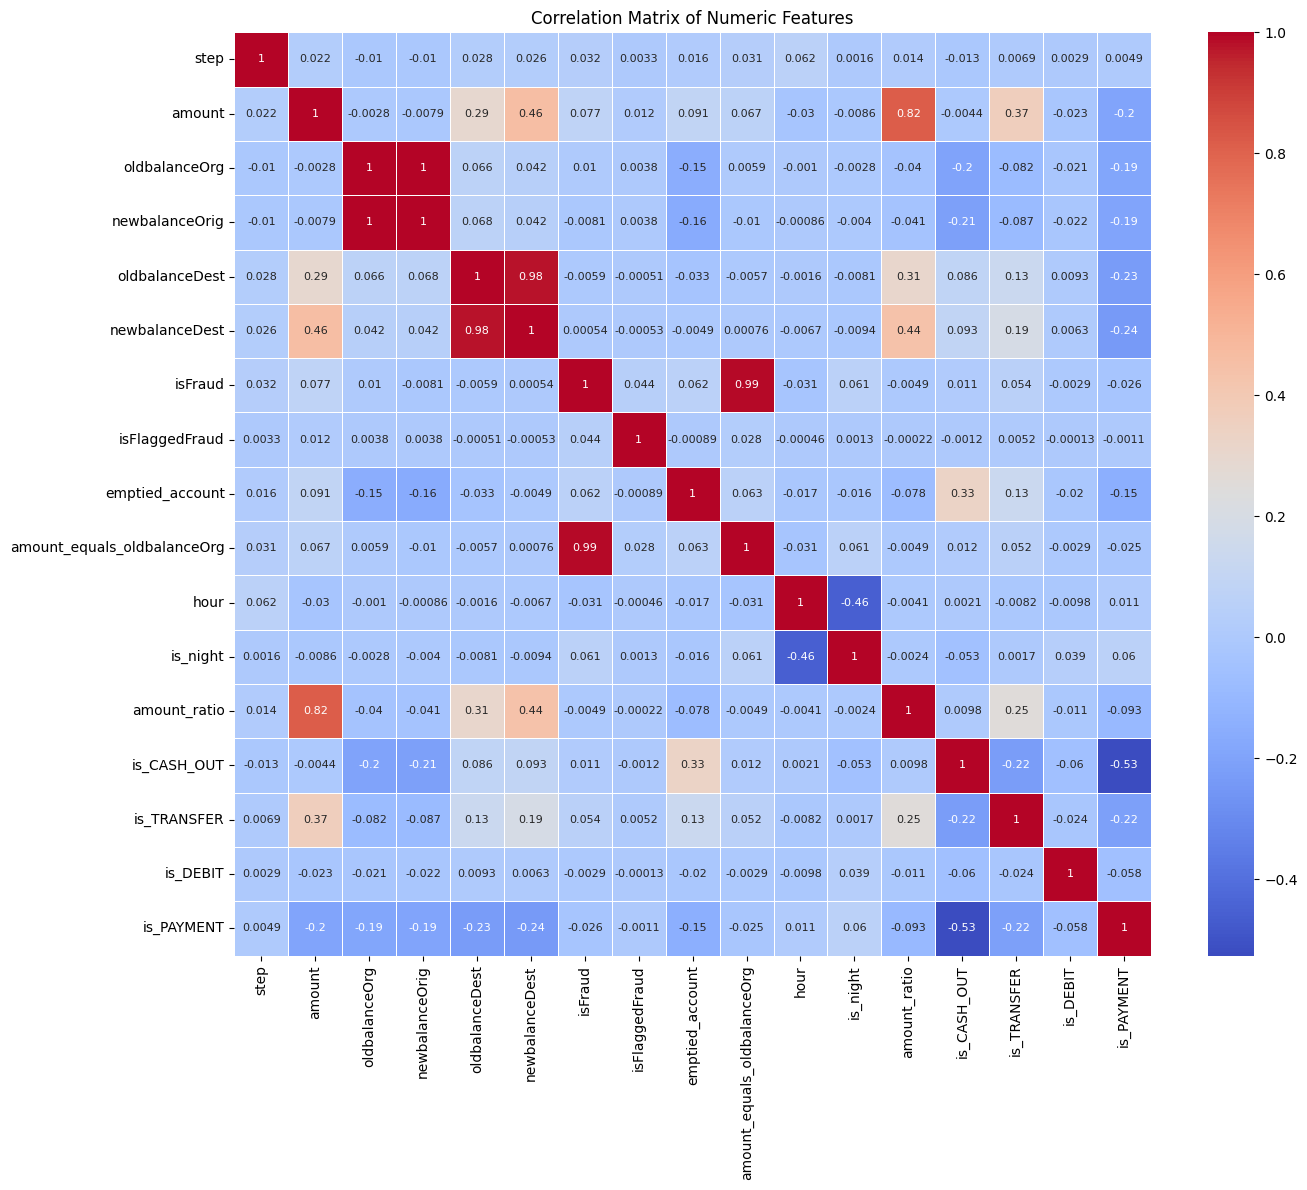
4 0 0 0 1 # Get only numeric columns - this automatically includes your type_encoded column
numeric_cols = df.select_dtypes(include=['number']).columns
corr = df[numeric_cols].corr()
# Visualize the correlation matrix
plt.figure(figsize=(14, 12))
sns.heatmap(corr, annot=True, cmap='coolwarm', linewidths=0.5, annot_kws={"size": 8})
plt.title('Correlation Matrix of Numeric Features')
plt.tight_layout()
plt.show()Out
# Drop unnecessary columns
columns_to_drop = [
    'isFlaggedFraud',
    'nameOrig',
    'nameDest',
    'type'
]

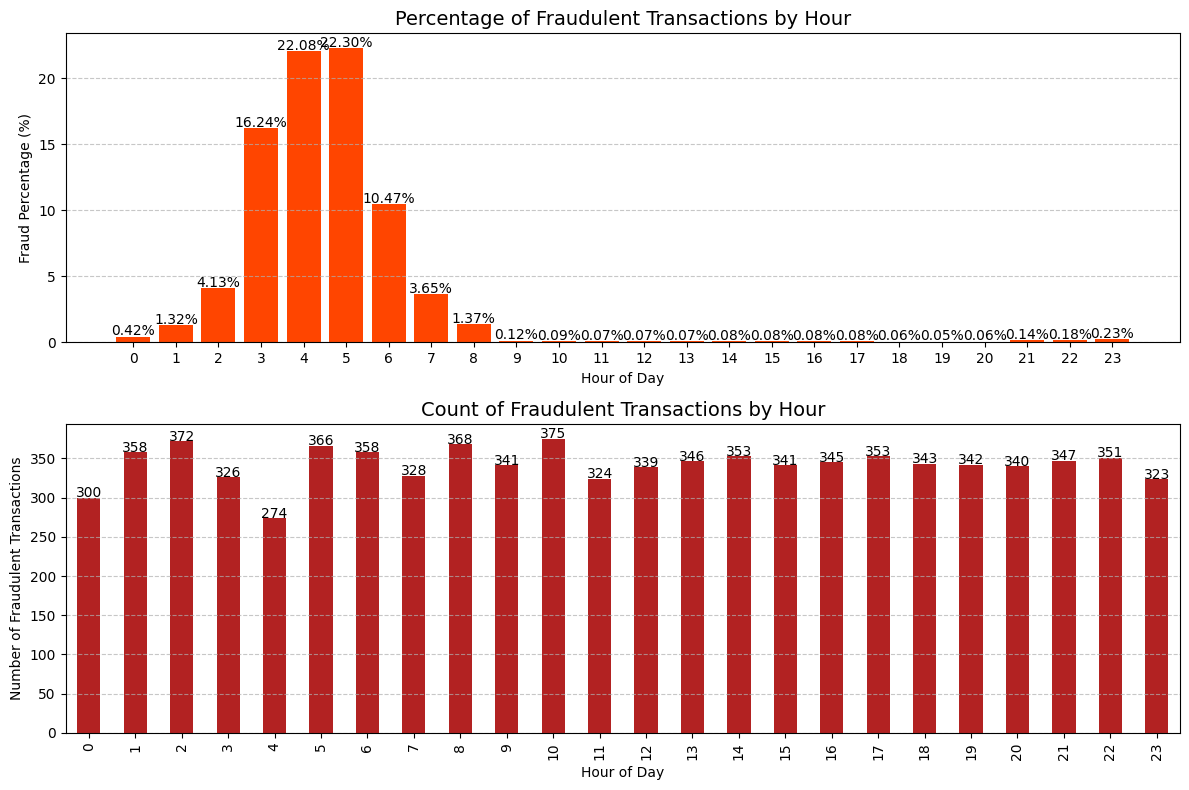
df = df.drop(columns=columns_to_drop)# Create a figure
plt.figure(figsize=(12, 8))
# Count fraud cases by hour
fraud_by_hour = df.groupby(['hour', 'isFraud']).size().unstack(fill_value=0)
if 1 in fraud_by_hour.columns:
# Plot percentage of fraud transactions by hour
fraud_percentage = fraud_by_hour[1] / (fraud_by_hour[0] + fraud_by_hour[1]) * 100
plt.subplot(2, 1, 1)
plt.bar(fraud_percentage.index, fraud_percentage.values, color='orangered')
plt.title('Percentage of Fraudulent Transactions by Hour', fontsize=14)
plt.xlabel('Hour of Day')
plt.ylabel('Fraud Percentage (%)')
plt.xticks(range(0, 24))
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Annotate percentages
for i, v in enumerate(fraud_percentage):
plt.text(i, v + 0.1, f'{v:.2f}%', ha='center')
# Plot count of fraud cases by hour
plt.subplot(2, 1, 2)
fraud_by_hour[1].plot(kind='bar', color='firebrick')
plt.title('Count of Fraudulent Transactions by Hour', fontsize=14)
plt.xlabel('Hour of Day')
plt.ylabel('Number of Fraudulent Transactions')
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Annotate counts
for i, v in enumerate(fraud_by_hour[1]):
plt.text(i, v + 0.5, str(v), ha='center')
else:
print("No fraud cases found in the dataset")
plt.tight_layout()
plt.show()Out
# Create a figure with stacked layout (one graph per figure for maximum size)
# First graph - Non-fraudulent transactions count
plt.figure(1)
fraud_by_hour = df.groupby(['hour', 'isFraud']).size().unstack(fill_value=0)

fraud_by_hour[0].plot(kind='bar', color='forestgreen', figsize=(20, 10))
plt.title('Count of Non-Fraudulent Transactions by Hour', fontsize=20)
plt.xlabel('Hour of Day', fontsize=16)
plt.ylabel('Number of Non-Fraudulent Transactions', fontsize=16)
plt.grid(axis='y', linestyle='--', alpha=0.7)
plt.ticklabel_format(axis='y', style='scientific', scilimits=(0,0))
plt.xticks(fontsize=14)
plt.yticks(fontsize=14)

# Annotate counts (scientific notation for large numbers)
for i, v in enumerate(fraud_by_hour[0]):
    plt.text(i, v + v*0.01, f'{v:.1e}', ha='center', fontsize=12)

plt.tight_layout(pad=1.1)

# Second graph - Combined log scale view on a separate figure
plt.figure(2, figsize=(20, 10))
fraud_by_hour.plot(kind='bar', log=True, figsize=(20, 10))
plt.title('Fraudulent vs Non-Fraudulent Transactions by Hour (Log Scale)', fontsize=20)
plt.xlabel('Hour of Day', fontsize=16)
plt.ylabel('Number of Transactions (Log Scale)', fontsize=16)
plt.grid(axis='y', linestyle='--', alpha=0.7)
plt.legend(['Non-Fraud', 'Fraud'], fontsize=16)
plt.xticks(fontsize=14)
plt.yticks(fontsize=14)

plt.tight_layout(pad=1.1)

# Display the figures in fullscreen mode
plt.show()
Out
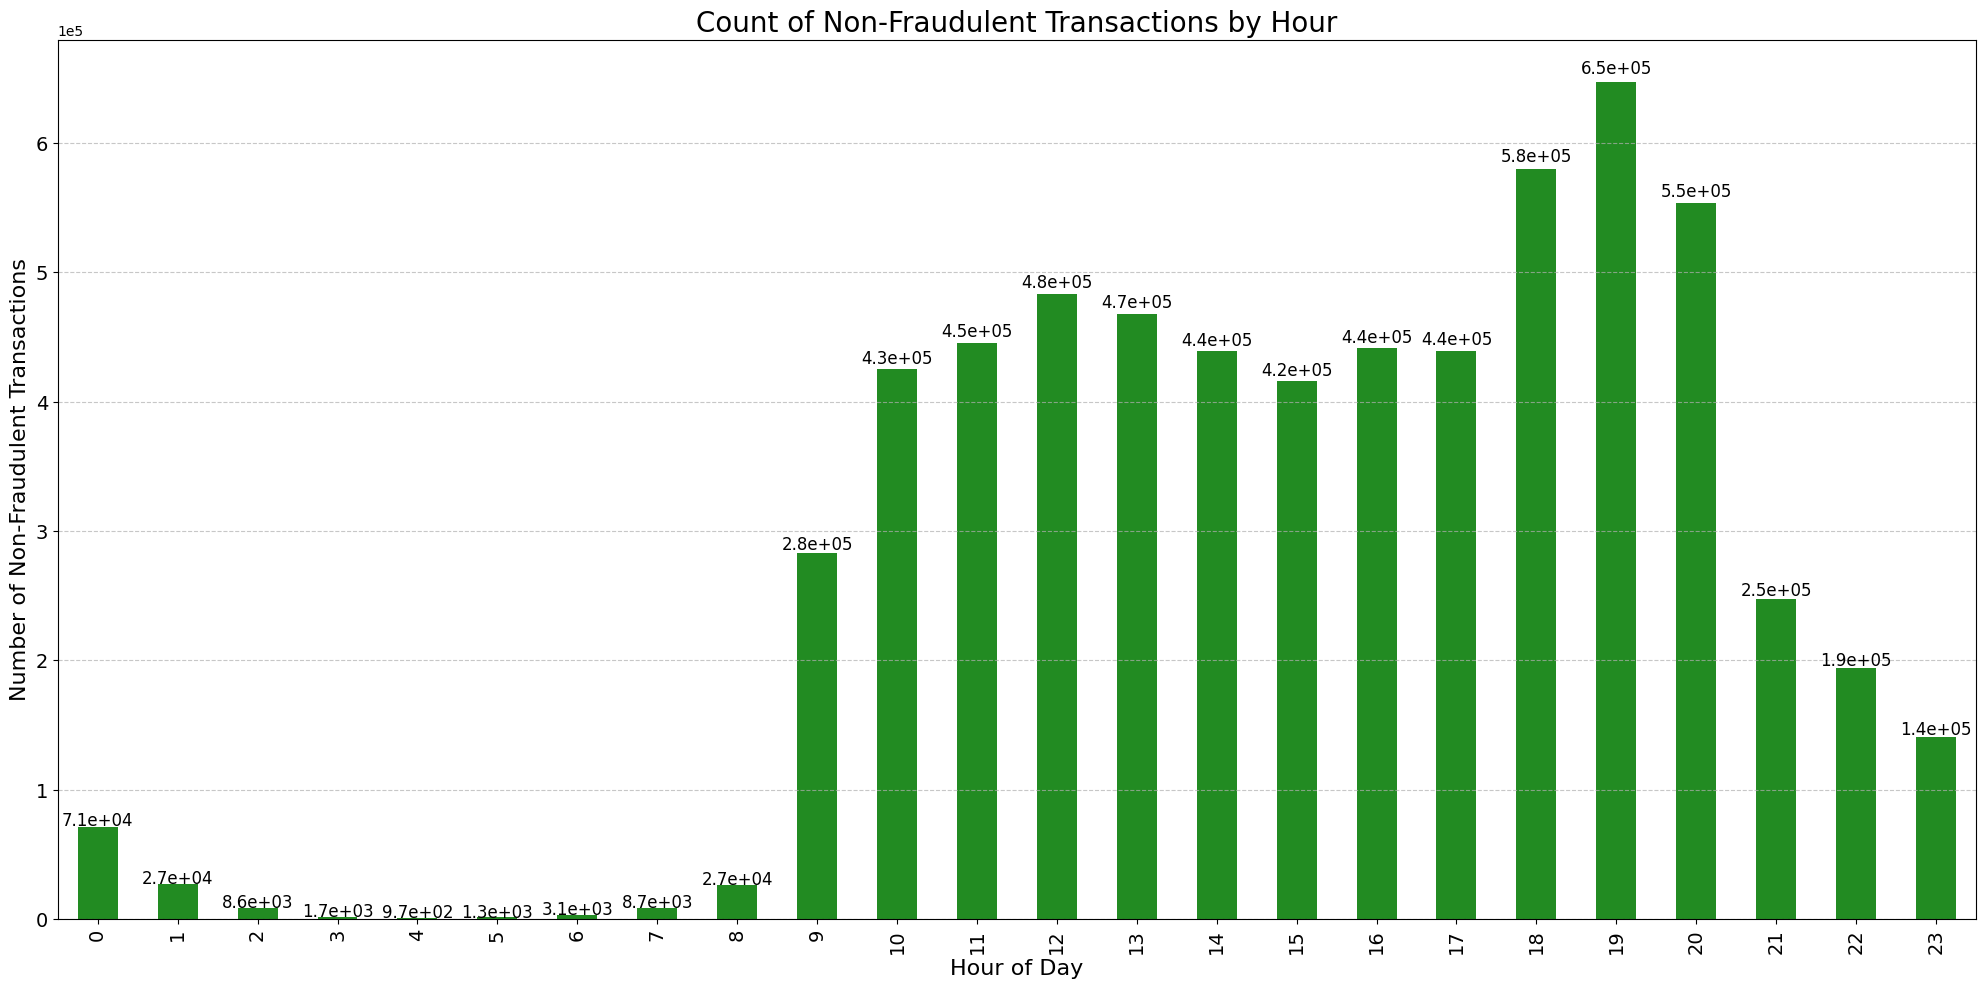
<Figure size 2000x1000 with 0 Axes>
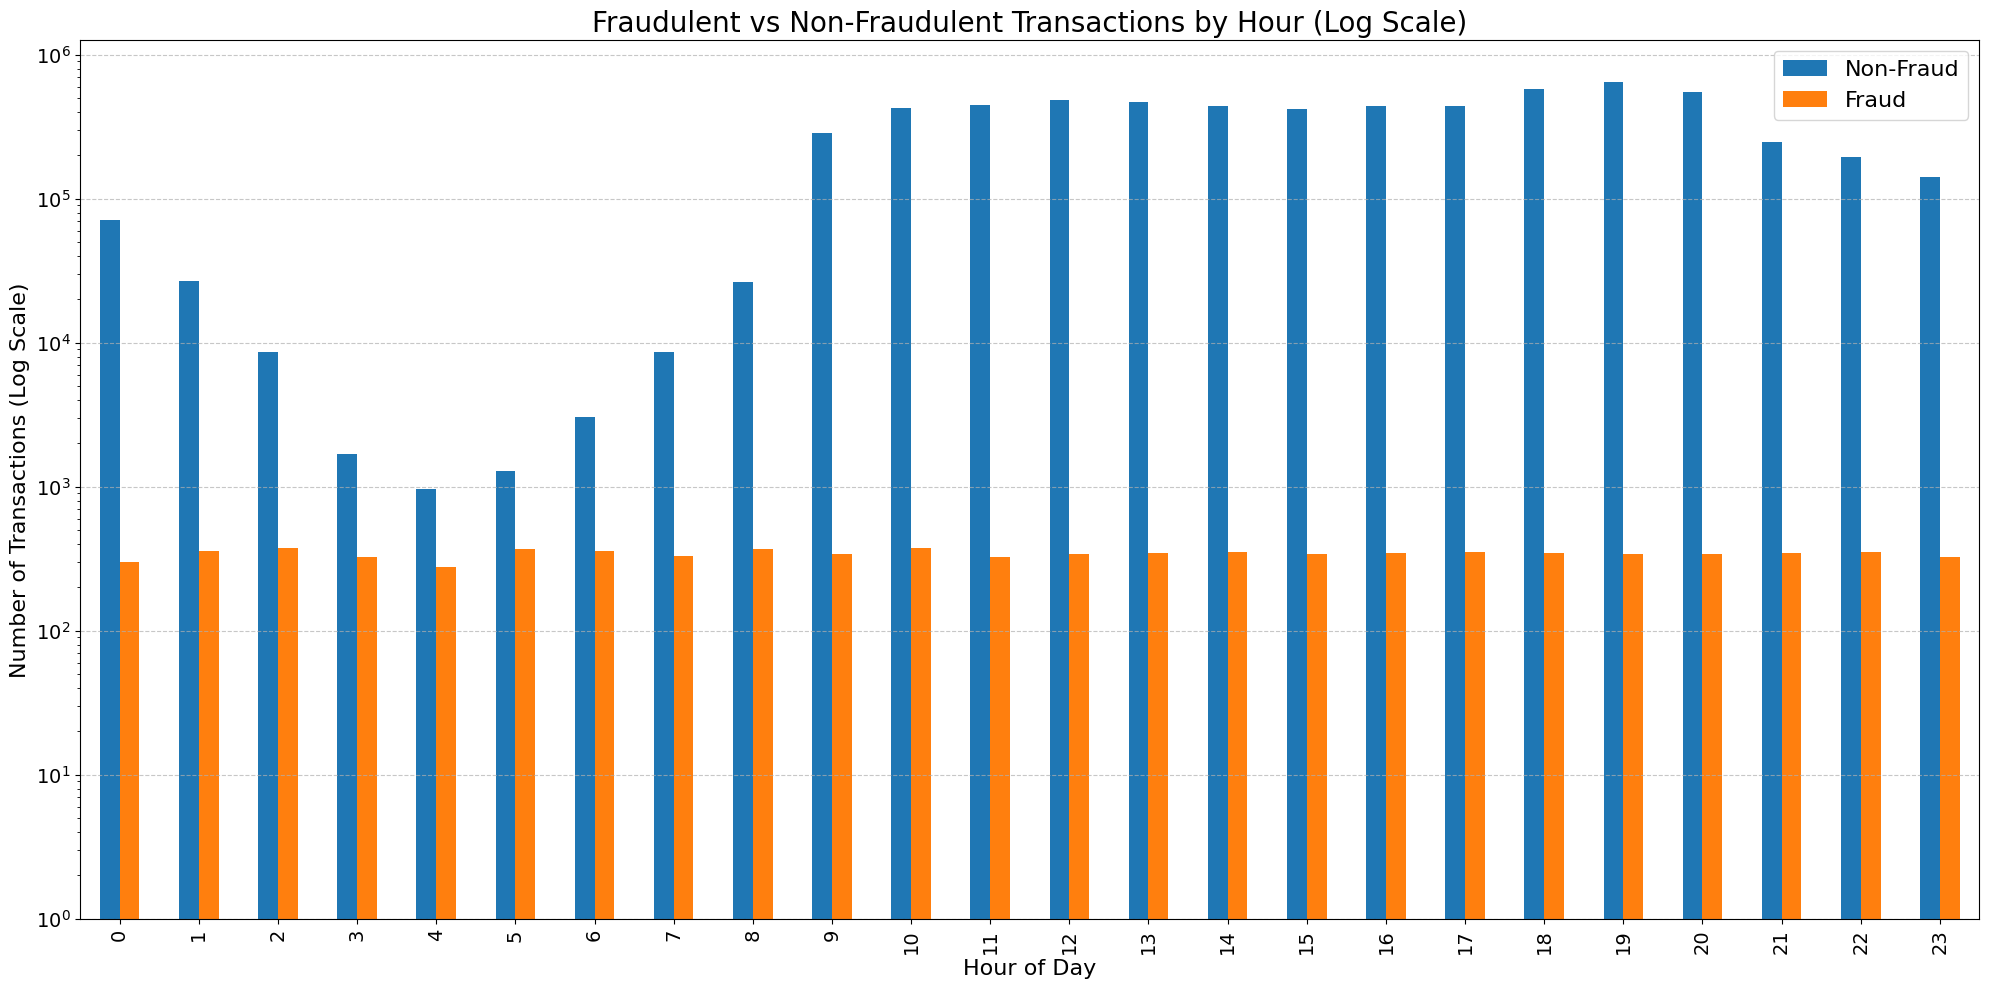
# Create hour risk categories based on fraud percentages
def assign_hour_risk(hour):
    if hour in [4, 5]:  # >20% fraud
        return 3  # Very high risk
    elif hour in [3, 6]:  # 10-20% fraud
        return 2  # High risk
    elif hour in [2, 7]:  # 3-10% fraud
        return 1  # Medium risk
    else:  # <1% fraud
        return 0  # Low risk

df['hour_risk_level'] = df['hour'].apply(assign_hour_risk)
# Drop unnecessary columns
columns_to_drop1 = [
    "is_night",
    "hour",
    "step",
    "amount_ratio",
    "is_DEBIT",
    "oldbalanceDest",
    "newbalanceOrig",
    "is_PAYMENT",
    "amount"
]

df = df.drop(columns=columns_to_drop1)# df.to_excel('transformed_fraud_dataset.xlsx', index=False)
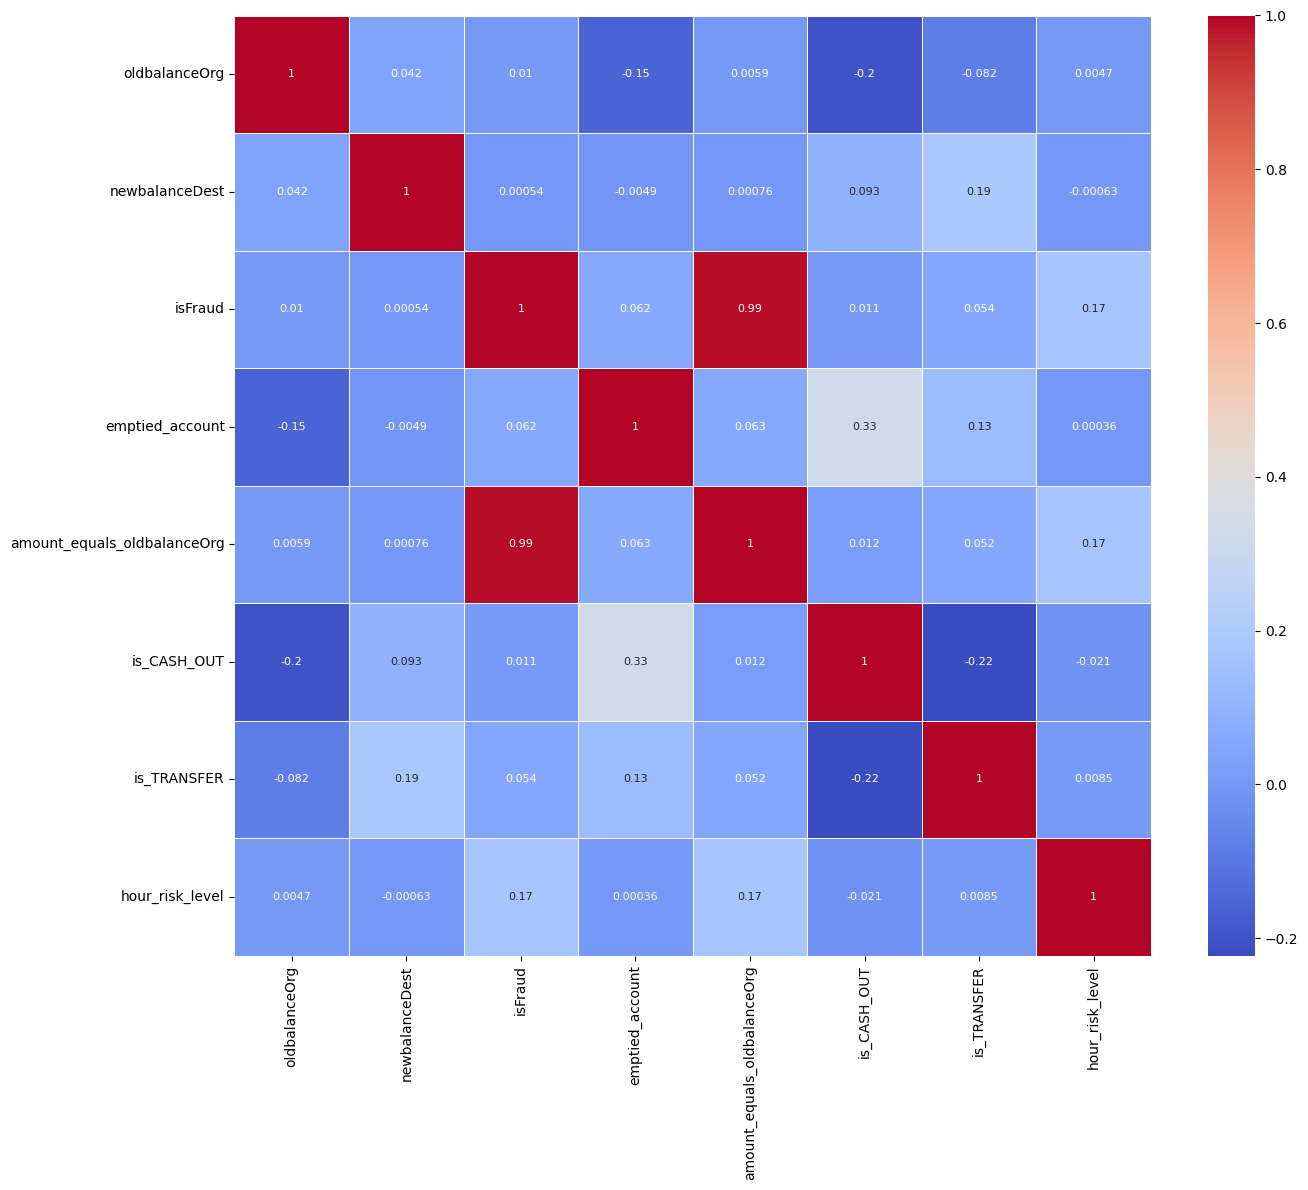
df.to_csv('transformed_fraud_dataset.csv', index=False)# Get only numeric columns - this automatically includes your type_encoded column
numeric_cols = df.select_dtypes(include=['number']).columns
corr = df[numeric_cols].corr()
# Visualize the correlation matrix
plt.figure(figsize=(14, 12))
sns.heatmap(corr, annot=True, cmap='coolwarm', linewidths=0.5, annot_kws={"size": 8})
plt.title('')
plt.tight_layout()
plt.show()Out
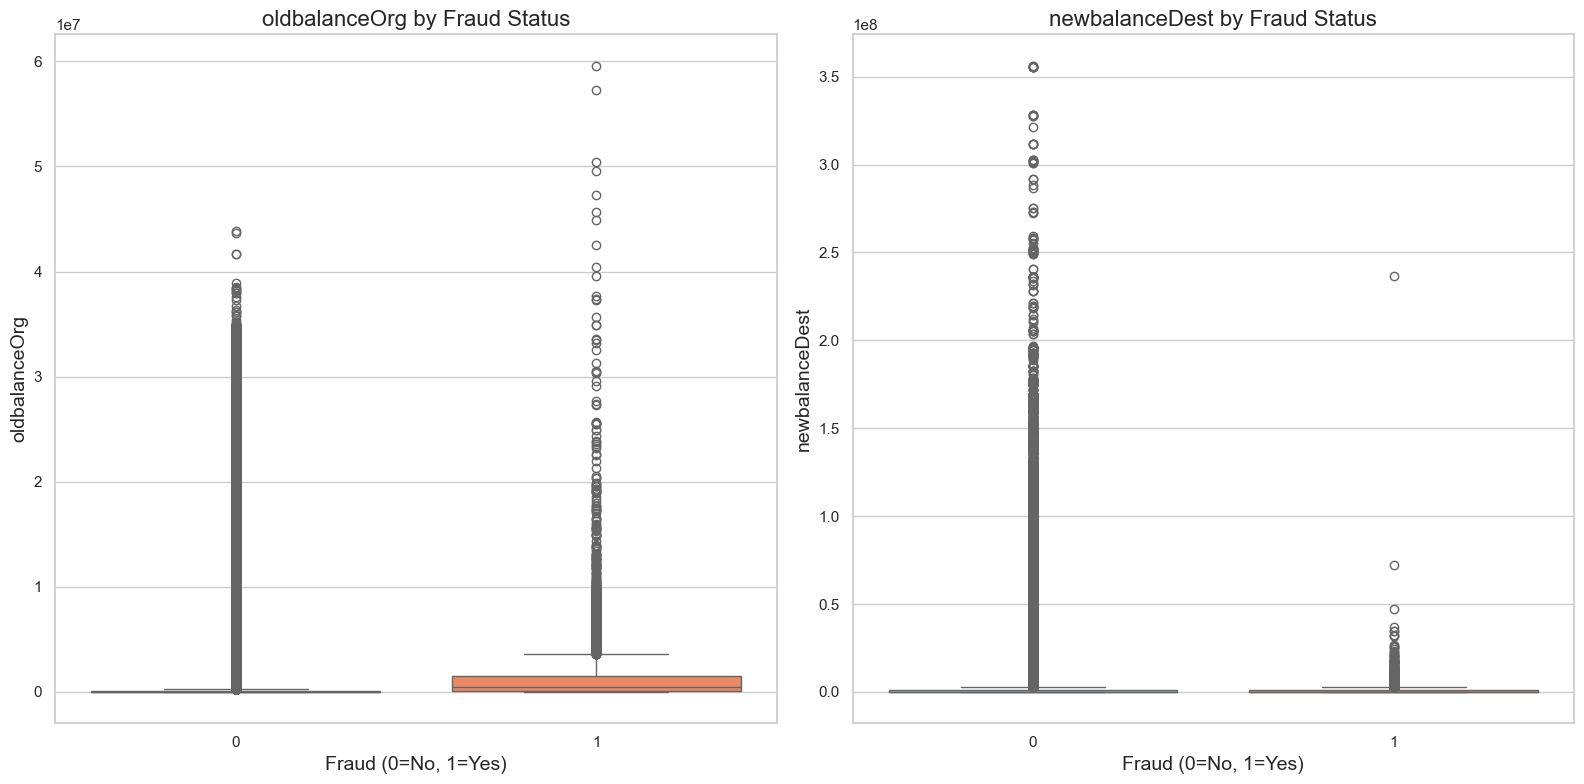
# Set the style for nicer plots
sns.set_theme(style="whitegrid")
plt.rcParams.update({'font.size': 12})


# Create a figure with 1 row and 2 columns
fig, axes = plt.subplots(1, 2, figsize=(16, 8))

# 1. oldbalanceOrg boxplot
sns.boxplot(x='isFraud', y='oldbalanceOrg', data=df, ax=axes[0],
            palette=['skyblue', 'coral'])
axes[0].set_title('oldbalanceOrg by Fraud Status', fontsize=16)
axes[0].set_xlabel('Fraud (0=No, 1=Yes)', fontsize=14)
axes[0].set_ylabel('oldbalanceOrg', fontsize=14)

# 2. newbalanceDest boxplot
sns.boxplot(x='isFraud', y='newbalanceDest', data=df, ax=axes[1],
            palette=['skyblue', 'coral'])
axes[1].set_title('newbalanceDest by Fraud Status', fontsize=16)
axes[1].set_xlabel('Fraud (0=No, 1=Yes)', fontsize=14)
axes[1].set_ylabel('newbalanceDest', fontsize=14)

# Adjust layout and save
plt.tight_layout()
plt.show()
Out
dfOut
         oldbalanceOrg  newbalanceDest  isFraud  emptied_account  \
0            170136.00            0.00        0                0
1             21249.00            0.00        0                0
2               181.00            0.00        1                1
3               181.00            0.00        1                1
4             41554.00            0.00        0                0
...                ...             ...      ...              ...
6362615      339682.13       339682.13        1                1
6362616     6311409.28            0.00        1                1
6362617     6311409.28      6379898.11        1                1
6362618      850002.52            0.00        1                1
6362619      850002.52      7360101.63        1                1

         amount_equals_oldbalanceOrg  is_CASH_OUT  is_TRANSFER  \
0                                  0            0            0
1                                  0            0            0
2                                  1            0            1
3                                  1            1            0
4                                  0            0            0
...                              ...          ...          ...
6362615                            1            1            0
6362616                            1            0            1
6362617                            1            1            0
6362618                            1            0            1
6362619                            1            1            0

         hour_risk_level
0                      0
1                      0
2                      0
3                      0
4                      0
...                  ...
6362615                0
6362616                0
6362617                0
6362618                0
6362619                0

[6362620 rows x 8 columns]# Show correlations with fraud
fraud_correlations = df.corr()['isFraud'].sort_values(ascending=False)
print("Correlation of features with fraud:")
print(fraud_correlations)Out
Correlation of features with fraud:
isFraud                        1.000000
amount_equals_oldbalanceOrg    0.989029
hour_risk_level                0.170055
emptied_account                0.062091
is_TRANSFER                    0.053869
is_CASH_OUT                    0.011256
oldbalanceOrg                  0.010154
newbalanceDest                 0.000535
Name: isFraud, dtype: float64
# X Data
X = df.drop(['isFraud'], axis=1)
print('X shape is : ' , X.shape)
print()

# y Data
y = df['isFraud']
print('y shape is : ' , y.shape)
Out
X shape is :  (6362620, 7)

y shape is :  (6362620,)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42, shuffle=True)

# Splitted Data
print('X_train shape is ' , X_train.shape)
print('X_test shape is ' , X_test.shape)
print('y_train shape is ' , y_train.shape)
print('y_test shape is ' , y_test.shape)
Out
X_train shape is  (4453834, 7)
X_test shape is  (1908786, 7)
y_train shape is  (4453834,)
y_test shape is  (1908786,)
# XGBoost Model
# Scale the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# Calculate class weights since the dataset is imbalanced
fraud_ratio = len(y_train[y_train==1]) / len(y_train[y_train==0])
scale_pos_weight = 1 / fraud_ratio

# Initialize XGBoost model with basic parameters
xgb_model = xgb.XGBClassifier(
    scale_pos_weight=scale_pos_weight, # Helps address class imbalance
    learning_rate=0.01, # Learning rate for the model
    n_estimators=200, # Number of trees in the model
    max_depth=5, # Maximum depth of the trees
    min_child_weight=1, # Minimum sum of instance weights (hessians) needed in a child
    gamma=0, # Minimum loss reduction required to make a split
    subsample=0.8, # Subsample ratio of the training instance  Uses 80% of data and features for each tree
    colsample_bytree=0.8, # Subsample ratio of columns when constructing each tree
    random_state=42
)

# Simple fit without additional parameters
xgb_model.fit(X_train_scaled, y_train)

# Evaluate on training data
train_preds = xgb_model.predict(X_train_scaled)
train_probs = xgb_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
test_preds = xgb_model.predict(X_test_scaled)
test_probs = xgb_model.predict_proba(X_test_scaled)[:, 1]

# Calculate metrics for both sets (correctly multiply by 100)
train_metrics = {
    'Accuracy': accuracy_score(y_train, train_preds) * 100,
    'Precision': precision_score(y_train, train_preds) * 100,
    'Recall': recall_score(y_train, train_preds) * 100,
    'F1 Score': f1_score(y_train, train_preds) * 100,
    'ROC AUC': roc_auc_score(y_train, train_probs) * 100,
    'PR AUC': average_precision_score(y_train, train_probs) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, test_preds) * 100,
    'Precision': precision_score(y_test, test_preds) * 100,
    'Recall': recall_score(y_test, test_preds) * 100,
    'F1 Score': f1_score(y_test, test_preds) * 100,
    'ROC AUC': roc_auc_score(y_test, test_probs) * 100,
    'PR AUC': average_precision_score(y_test, test_probs) * 100
}

# Format metrics with 8 decimal places
print("\n---------- XGBoost Model Performance ----------")
print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>20} {'Test':>20} {'Difference':>20}")
print("-" * 74)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>19.8f}% {test_metrics[metric]:>19.8f}% {diff:>19.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis and 8 decimal places
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, test_preds))

# Create confusion matrix
cm = confusion_matrix(y_test, test_preds)
plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - XGBoost')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()
Out
---------- XGBoost Model Performance ----------

---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric                   Training                 Test           Difference
--------------------------------------------------------------------------
Accuracy             99.99946114%         99.99931894%          0.00014220%
Precision            99.96508989%         99.83733225%          0.12775764%
Recall               99.61732475%         99.63474026%         -0.01741551%
F1 Score             99.79090434%         99.73593337%          0.05497096%
ROC AUC              99.93566535%         99.92032587%          0.01533947%
PR AUC               99.66588739%         99.63693768%          0.02894971%

Overfitting Score: 0.03495741%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99931894 %
➤➤➤ Precision: 99.83733225 %
➤➤➤ Recall: 99.63474026 %
➤➤➤ F1 Score: 99.73593337 %
➤➤➤ ROC AUC: 99.92032587 %
➤➤➤ PR AUC: 99.63693768 %

Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906322
           1       1.00      1.00      1.00      2464

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786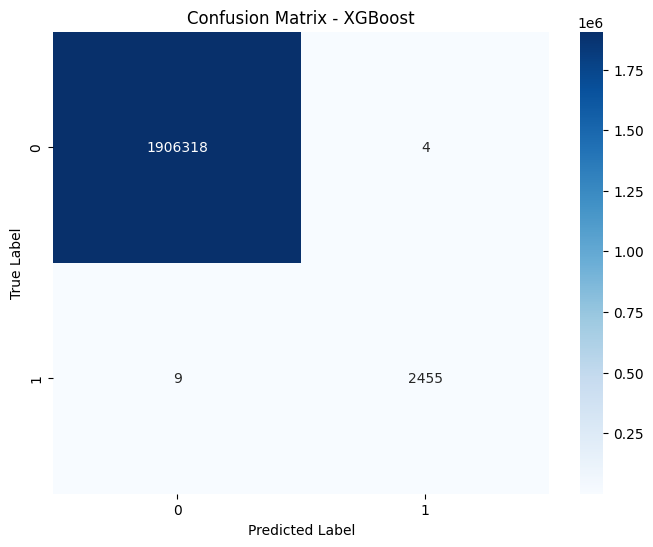
# LightGBM Model

# 1. Feature Scaling
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 2. Calculate class weights
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
class_weight = {0: 1.0, 1: non_fraud_samples / fraud_samples}
print(f"Class weights: {class_weight}")
Out
Class weights: {0: 1.0, 1: 769.8262374524056}# 3. Model Training
lgb_model = lgb.LGBMClassifier(
objective='binary',
metric='auc',
boosting_type='gbdt',
learning_rate=0.01,
num_leaves=31,
max_depth=7,
feature_fraction=0.8,
bagging_fraction=0.8,
bagging_freq=5,
verbose=-1,
is_unbalance=True,
class_weight='balanced',
random_state=42,
n_estimators=200
)
lgb_model.fit(X_train_scaled, y_train)Out
LGBMClassifier(bagging_fraction=0.8, bagging_freq=5, class_weight='balanced',
               feature_fraction=0.8, is_unbalance=True, learning_rate=0.01,
               max_depth=7, metric='auc', n_estimators=200, objective='binary',
random_state=42, verbose=-1)# 4. Model Evaluation
# Evaluate on training data
y_train_pred = lgb_model.predict(X_train_scaled)
y_train_pred_proba = lgb_model.predict_proba(X_train_scaled)[:, 1]
# Evaluate on test data
y_pred_lgb = lgb_model.predict(X_test_scaled)
y_pred_proba_lgb = lgb_model.predict_proba(X_test_scaled)[:, 1]
print("\n---------- LightGBM Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_lgb))
# Calculate metrics for both training and test sets
train_metrics = {
'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
'Precision': precision_score(y_train, y_train_pred) * 100,
'Recall': recall_score(y_train, y_train_pred) * 100,
'F1 Score': f1_score(y_train, y_train_pred) * 100,
'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}
test_metrics = {
'Accuracy': accuracy_score(y_test, y_pred_lgb) * 100,
'Precision': precision_score(y_test, y_pred_lgb) * 100,
'Recall': recall_score(y_test, y_pred_lgb) * 100,
'F1 Score': f1_score(y_test, y_pred_lgb) * 100,
'ROC AUC': roc_auc_score(y_test, y_pred_proba_lgb) * 100,
'PR AUC': average_precision_score(y_test, y_pred_proba_lgb) * 100
}
print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
diff = train_metrics[metric] - test_metrics[metric]
print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")
# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
print("Model shows good generalization (score < 2%)")
else:
print("Model shows moderate overfitting")
# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
print(f'➤➤➤ {metric}: {value:.8f} %')Out
---------- LightGBM Model Evaluation ----------

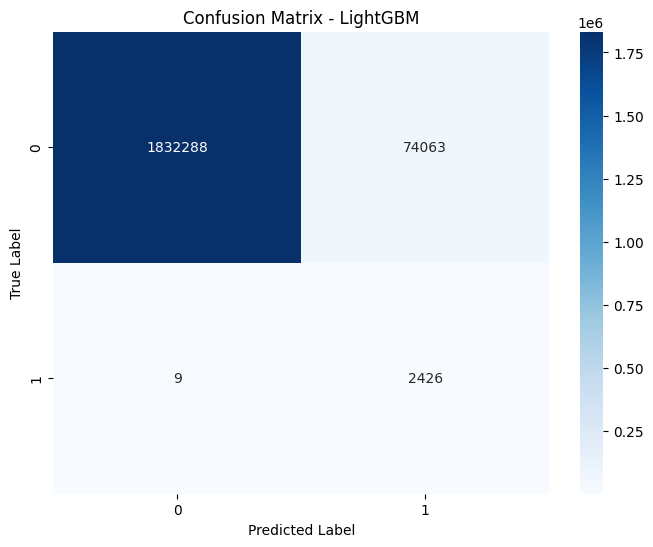
Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      0.96      0.98   1906351
           1       0.03      1.00      0.06      2435

    accuracy                           0.96   1908786
   macro avg       0.52      0.98      0.52   1908786
weighted avg       1.00      0.96      0.98   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     96.09817070% 96.11941831% -0.02124761%
Precision     3.21788382%  3.17169789%  0.04618592%
Recall       100.00000000% 99.63039014%  0.36960986%
F1 Score      6.23512844%  6.14768638%  0.08744206%
ROC AUC      99.99321876% 99.92273862%  0.07048014%
PR AUC       99.66835778% 99.37808337%  0.29027441%

Overfitting Score: 0.14045746%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 96.11941831 %
➤➤➤ Precision: 3.17169789 %
➤➤➤ Recall: 99.63039014 %
➤➤➤ F1 Score: 6.14768638 %
➤➤➤ ROC AUC: 99.92273862 %
➤➤➤ PR AUC: 99.37808337 %# 5. Visualization
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_lgb)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - LightGBM')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
# Random Forest Model

# 1. Performance Tracking
start_time = time.time()

# 2. Feature Scaling
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 3. Calculate class weights
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
class_weight_ratio = non_fraud_samples / fraud_samples
print(f"Class weight ratio (non-fraud:fraud): {class_weight_ratio:.2f}:1")
Out
Class weight ratio (non-fraud:fraud): 769.83:1
# 4. Model Training
print("Training Random Forest model...")
rf_model = RandomForestClassifier(
    n_estimators=100,
    max_depth=10,
    min_samples_split=10,
    min_samples_leaf=4,
    max_features='sqrt',
    bootstrap=True,
    class_weight='balanced',
    n_jobs=-1,
    random_state=42
)

rf_model.fit(X_train_scaled, y_train)
training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training Random Forest model...
Training completed in 41.33 seconds
# 5. Model Evaluation
# Evaluate on training data
y_train_pred = rf_model.predict(X_train_scaled)
y_train_pred_proba = rf_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
y_pred_rdf = rf_model.predict(X_test_scaled)
y_pred_proba_rdf = rf_model.predict_proba(X_test_scaled)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

print("\n---------- Random Forest Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_rdf))

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
    'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_rdf) * 100,
    'Precision': precision_score(y_test, y_pred_rdf) * 100,
    'Recall': recall_score(y_test, y_pred_rdf) * 100,
    'F1 Score': f1_score(y_test, y_pred_rdf) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_rdf) * 100,
    'PR AUC': average_precision_score(y_test, y_pred_proba_rdf) * 100
}

print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')
Out
Predictions completed in 7.91 seconds

---------- Random Forest Model Evaluation ----------

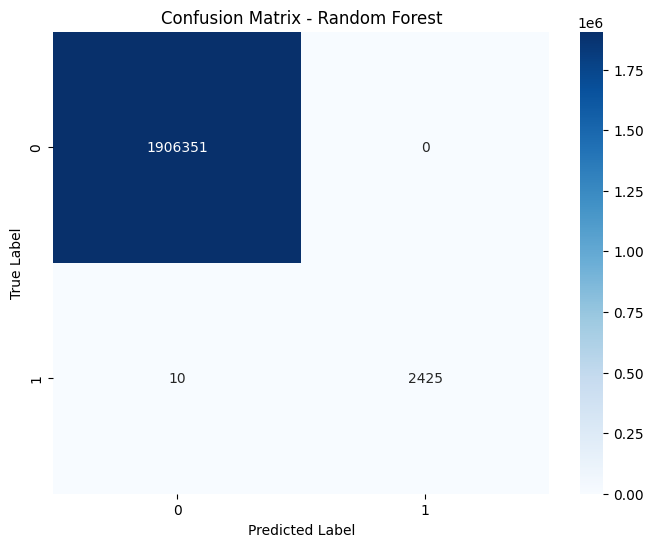
Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       1.00      1.00      1.00      2435

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99964076% 99.99947611%  0.00016465%
Precision    99.98265094% 100.00000000% -0.01734906%
Recall       99.74039460% 99.58932238%  0.15107222%
F1 Score     99.86137584% 99.79423868%  0.06713716%
ROC AUC      99.99999384% 99.89835514%  0.10163870%
PR AUC       99.99539746% 99.59533927%  0.40005819%

Overfitting Score: 0.11712031%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99947611 %
➤➤➤ Precision: 100.00000000 %
➤➤➤ Recall: 99.58932238 %
➤➤➤ F1 Score: 99.79423868 %
➤➤➤ ROC AUC: 99.89835514 %
➤➤➤ PR AUC: 99.59533927 %# 6. Visualization
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_rdf)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - Random Forest')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
# 1. Performance Tracking
start_time = time.time()

# 2. Feature Scaling
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 3. Class Weight Calculation
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
print(f"Training data: {non_fraud_samples} non-fraud, {fraud_samples} fraud")
print(f"Class distribution ratio (non-fraud:fraud): {non_fraud_samples / fraud_samples:.2f}:1")

# Define different class weight options
weight_options = {
    'balanced': 'balanced',
    'inverse': {
        0: 1.0,
        1: non_fraud_samples / fraud_samples
    },
    'sqrt': {
        0: 1.0,
        1: np.sqrt(non_fraud_samples / fraud_samples)
    },
    'custom': {
        0: 1.0,
        1: 2 * (non_fraud_samples / fraud_samples)
    }
}

# Select weight approach
selected_weight = weight_options['inverse']  # Choose from: 'balanced', 'inverse', 'sqrt', 'custom'
print(f"\nSelected weight approach: {selected_weight}")
Out
Training data: 4448056 non-fraud, 5778 fraud
Class distribution ratio (non-fraud:fraud): 769.83:1

Selected weight approach: {0: 1.0, 1: 769.8262374524056}# 4. Model Training
print("\nTraining Logistic Regression model...")
lr_model = LogisticRegression(
penalty='l2',
C=1.0,
class_weight=selected_weight,
solver='liblinear',
max_iter=1000,
verbose=1,
n_jobs=-1,
random_state=42
)
lr_model.fit(X_train_scaled, y_train)
training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")Out
Training Logistic Regression model...
[LibLinear]iter  1 act 2.465e+06 pre 2.175e+06 delta 8.073e-02 f 6.166e+06 |g| 6.218e+07 CG   1
cg reaches trust region boundary
iter  2 act 5.243e+05 pre 4.466e+05 delta 1.306e-01 f 3.701e+06 |g| 1.502e+07 CG   2
cg reaches trust region boundary
iter  3 act 3.805e+05 pre 3.436e+05 delta 3.194e-01 f 3.177e+06 |g| 5.504e+06 CG   2
cg reaches trust region boundary
iter  4 act 6.092e+05 pre 5.362e+05 delta 8.973e-01 f 2.796e+06 |g| 2.523e+06 CG   2
cg reaches trust region boundary
iter  5 act 1.097e+06 pre 1.049e+06 delta 1.725e+00 f 2.187e+06 |g| 1.653e+06 CG   1
iter  6 act 6.422e+05 pre 5.220e+05 delta 1.725e+00 f 1.089e+06 |g| 8.539e+05 CG   1
iter  7 act 2.027e+05 pre 1.608e+05 delta 1.725e+00 f 4.473e+05 |g| 2.943e+05 CG   3
iter  8 act 7.715e+04 pre 6.031e+04 delta 1.725e+00 f 2.447e+05 |g| 1.103e+05 CG   6
iter  9 act 3.525e+04 pre 2.711e+04 delta 2.008e+00 f 1.675e+05 |g| 4.095e+04 CG   5
iter 10 act 1.954e+04 pre 1.476e+04 delta 2.780e+00 f 1.323e+05 |g| 1.667e+04 CG   5
iter 11 act 1.190e+04 pre 9.134e+03 delta 3.819e+00 f 1.127e+05 |g| 8.263e+03 CG   7
iter 12 act 6.131e+03 pre 4.821e+03 delta 4.906e+00 f 1.008e+05 |g| 4.381e+03 CG   8
iter 13 act 2.282e+03 pre 1.825e+03 delta 4.906e+00 f 9.468e+04 |g| 2.729e+03 CG   8
iter 14 act 7.609e+02 pre 6.087e+02 delta 4.906e+00 f 9.240e+04 |g| 1.783e+03 CG   8
iter 15 act 2.354e+02 pre 1.919e+02 delta 4.906e+00 f 9.164e+04 |g| 9.061e+02 CG   8
iter 16 act 5.220e+01 pre 4.451e+01 delta 4.906e+00 f 9.141e+04 |g| 3.416e+02 CG   8
iter 17 act 6.070e+00 pre 5.454e+00 delta 4.906e+00 f 9.135e+04 |g| 1.115e+02 CG   8
iter 18 act 2.260e-01 pre 2.036e-01 delta 4.906e+00 f 9.135e+04 |g| 2.738e+01 CG   7
Training completed in 8.32 seconds
# 5. Model Evaluation
# Evaluate on training data
y_train_pred = lr_model.predict(X_train_scaled)
y_train_pred_proba = lr_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
y_pred_lr = lr_model.predict(X_test_scaled)
y_pred_proba_lr = lr_model.predict_proba(X_test_scaled)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

print("\n---------- Logistic Regression Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_lr))

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
    'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_lr) * 100,
    'Precision': precision_score(y_test, y_pred_lr) * 100,
    'Recall': recall_score(y_test, y_pred_lr) * 100,
    'F1 Score': f1_score(y_test, y_pred_lr) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_lr) * 100,
    'PR AUC': average_precision_score(y_test, y_pred_proba_lr) * 100
}

print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')
Out
Predictions completed in 7.43 seconds

---------- Logistic Regression Model Evaluation ----------

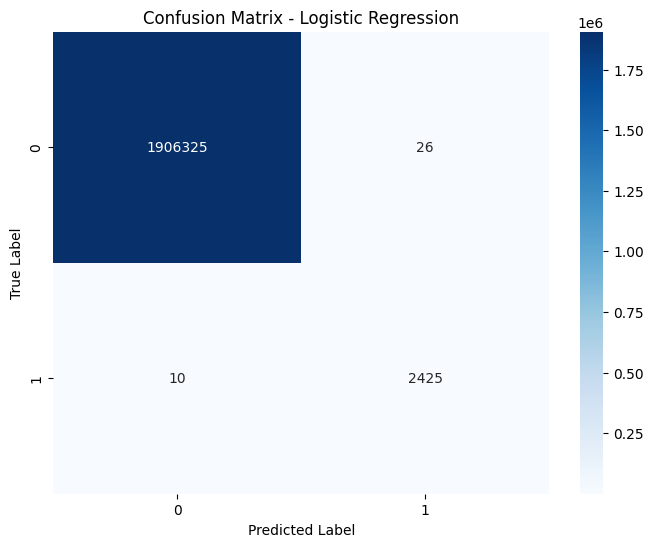
Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       0.99      1.00      0.99      2435

    accuracy                           1.00   1908786
   macro avg       0.99      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99833851% 99.99811398%  0.00022453%
Precision    99.08777969% 98.93920849%  0.14857120%
Recall       99.63655244% 99.58932238%  0.04723006%
F1 Score     99.36140835% 99.26320098%  0.09820737%
ROC AUC      99.95103785% 99.96167577% -0.01063792%
PR AUC       99.65451640% 99.59721978%  0.05729662%

Overfitting Score: 0.05681531%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99811398 %
➤➤➤ Precision: 98.93920849 %
➤➤➤ Recall: 99.58932238 %
➤➤➤ F1 Score: 99.26320098 %
➤➤➤ ROC AUC: 99.96167577 %
➤➤➤ PR AUC: 99.59721978 %# 6. Visualization
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_lr)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - Logistic Regression')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
# 1. Performance Tracking
start_time = time.time()

# 2. Feature Scaling
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 3. Class Distribution Analysis
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
print(f"Training data: {non_fraud_samples} non-fraud, {fraud_samples} fraud")
print(f"Class distribution ratio (non-fraud:fraud): {non_fraud_samples / fraud_samples:.2f}:1")
Out
Training data: 4448056 non-fraud, 5778 fraud
Class distribution ratio (non-fraud:fraud): 769.83:1
# 4. Model Training
print("\nTraining k-Nearest Neighbors model...")
knn_model = KNeighborsClassifier(
    n_neighbors=5,          # Number of neighbors to consider
    weights='distance',     # Weight points by inverse of their distance
    algorithm='auto',       # Automatically choose the best algorithm
    leaf_size=30,          # Leaf size passed to BallTree or KDTree
    p=2,                   # Power parameter for the Minkowski metric (2 = Euclidean distance)
    metric='minkowski',    # Distance metric to use
    n_jobs=-1             # Use all available cores
)

knn_model.fit(X_train_scaled, y_train)
training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training k-Nearest Neighbors model...
Training completed in 5.08 seconds
# 5. Model Evaluation
# Evaluate on training data
y_train_pred = knn_model.predict(X_train_scaled)
y_train_pred_proba = knn_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
y_pred_knn = knn_model.predict(X_test_scaled)
y_pred_proba_knn = knn_model.predict_proba(X_test_scaled)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

print("\n---------- k-Nearest Neighbors Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_knn))

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_knn) * 100,
    'Precision': precision_score(y_test, y_pred_knn) * 100,
    'Recall': recall_score(y_test, y_pred_knn) * 100,
    'F1 Score': f1_score(y_test, y_pred_knn) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_knn) * 100
}

print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')
Out
Predictions completed in 9772.89 seconds

---------- k-Nearest Neighbors Model Evaluation ----------

Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       1.00      1.00      1.00      2435

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99995509% 99.99910938%  0.00084571%
Precision    100.00000000% 99.71217105%  0.28782895%
Recall       99.96538595% 99.58932238%  0.37606356%
F1 Score     99.98268998% 99.65070886%  0.33198112%
ROC AUC      99.99999999% 99.79457681%  0.20542318%

Overfitting Score: 0.24042851%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99910938 %
➤➤➤ Precision: 99.71217105 %
➤➤➤ Recall: 99.58932238 %
➤➤➤ F1 Score: 99.65070886 %
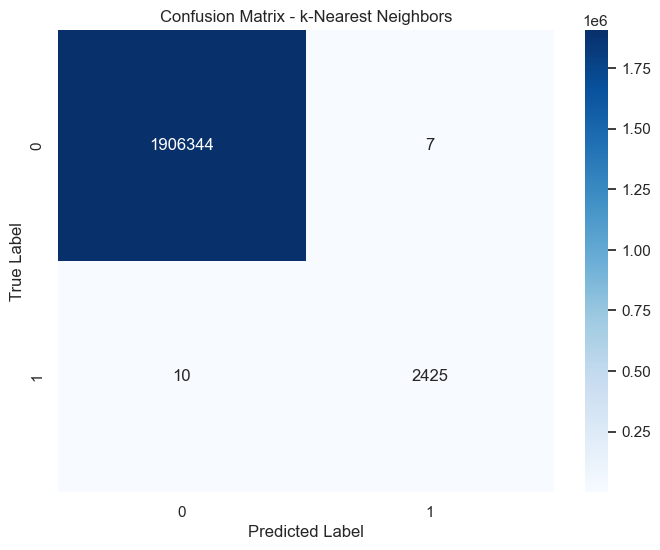
➤➤➤ ROC AUC: 99.79457681 %# 6. Visualization
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_knn)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - k-Nearest Neighbors')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
# Scale the features (optional for Decision Trees but keeping for consistency)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# Calculate class weights for imbalanced data
fraud_ratio = len(y_train[y_train==1]) / len(y_train[y_train==0])
class_weights = {0: 1, 1: 1/fraud_ratio}

# Initialize Decision Tree model with parameters
dt_model = DecisionTreeClassifier(
    class_weight=class_weights,  # Handle class imbalance
    max_depth=10,                # Control tree depth to prevent overfitting
    min_samples_split=50,        # Minimum samples required to split a node
    min_samples_leaf=20,         # Minimum samples required at a leaf node
    criterion='gini',            # Use gini impurity
    random_state=42              # For reproducibility
)

# Train the model
dt_model.fit(X_train_scaled, y_train)

# Evaluate on training data
train_preds = dt_model.predict(X_train_scaled)
train_probs = dt_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
test_preds = dt_model.predict(X_test_scaled)
test_probs = dt_model.predict_proba(X_test_scaled)[:, 1]

# Calculate metrics for both sets (as percentages)
train_metrics = {
    'Accuracy': accuracy_score(y_train, train_preds) * 100,
    'Precision': precision_score(y_train, train_preds) * 100,
    'Recall': recall_score(y_train, train_preds) * 100,
    'F1 Score': f1_score(y_train, train_preds) * 100,
    'ROC AUC': roc_auc_score(y_train, train_probs) * 100,
    'PR AUC': average_precision_score(y_train, train_probs) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, test_preds) * 100,
    'Precision': precision_score(y_test, test_preds) * 100,
    'Recall': recall_score(y_test, test_preds) * 100,
    'F1 Score': f1_score(y_test, test_preds) * 100,
    'ROC AUC': roc_auc_score(y_test, test_probs) * 100,
    'PR AUC': average_precision_score(y_test, test_probs) * 100
}

# Format metrics with 8 decimal places
print("\n---------- Decision Tree Model Performance ----------")
print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>20} {'Test':>20} {'Difference':>20}")
print("-" * 74)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>19.8f}% {test_metrics[metric]:>19.8f}% {diff:>19.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis and 8 decimal places
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, test_preds))
Out
---------- Decision Tree Model Performance ----------

---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric                   Training                 Test           Difference
--------------------------------------------------------------------------
Accuracy             99.99398271%         99.99329417%          0.00068855%
Precision            95.68822554%         95.35981125%          0.32841429%
Recall               99.86154379%         99.58932238%          0.27222140%
F1 Score             97.73035230%         97.42868622%          0.30166608%
ROC AUC              99.99867954%         99.81102432%          0.18765522%
PR AUC               99.87078692%         99.59165051%          0.27913640%

Overfitting Score: 0.22829699%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99329417 %
➤➤➤ Precision: 95.35981125 %
➤➤➤ Recall: 99.58932238 %
➤➤➤ F1 Score: 97.42868622 %
➤➤➤ ROC AUC: 99.81102432 %
➤➤➤ PR AUC: 99.59165051 %

Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       0.95      1.00      0.97      2435

    accuracy                           1.00   1908786
   macro avg       0.98      1.00      0.99   1908786
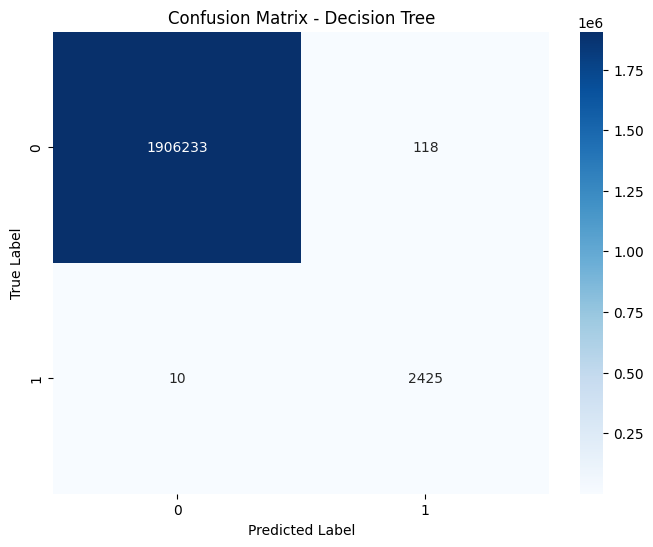
weighted avg 1.00 1.00 1.00 1908786# Create confusion matrix
cm = confusion_matrix(y_test, test_preds)
plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - Decision Tree')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
# Improved Outlier Handling
def handle_outliers(df, method='winsorize', z_threshold=4, columns_to_handle=None):
    """
    Enhanced outlier handling with column-specific treatment

    Parameters:
    -----------
    df : DataFrame
        The input dataframe
    method : str
        The method to handle outliers ('remove', 'winsorize', 'log', or 'robust_scale')
    z_threshold : float
        Threshold for Z-score outlier detection
    columns_to_handle : list
        Specific columns to apply outlier handling to (if None, applies to all numeric columns)
    """
    df_result = df.copy()

    # Select columns to process
    cols_to_process = columns_to_handle if columns_to_handle else df.select_dtypes(include=np.number).columns

    if method == 'remove':
        # Only calculate Z-scores for specified columns
        z_scores = np.abs(stats.zscore(df[cols_to_process]))
        outliers_z = (z_scores > z_threshold).any(axis=1)
        df_result = df[~outliers_z]
        print(f"\nRemoved {len(df) - len(df_result)} rows using Z-score method")

    elif method == 'winsorize':
        # Winsorization per column (capping extreme values)
        for col in cols_to_process:
            lower = df[col].quantile(0.01)  # Less aggressive lower bound
            upper = df[col].quantile(0.99)  # Less aggressive upper bound
            df_result[col] = np.clip(df[col], lower, upper)
        print(f"\nWinsorized {len(cols_to_process)} columns at 1% and 99% percentiles")

    elif method == 'log':
        # Log transformation for positive-valued columns
        for col in cols_to_process:
            if df[col].min() >= 0:  # Only apply to non-negative columns
                df_result[col] = np.log1p(df[col])
        print(f"\nApplied log transformation to applicable columns")

    elif method == 'robust_scale':
        # Robust scaling (less sensitive to outliers)
        from sklearn.preprocessing import RobustScaler
        scaler = RobustScaler()
        df_result[cols_to_process] = scaler.fit_transform(df[cols_to_process])
        print(f"\nApplied robust scaling to {len(cols_to_process)} columns")

    else:
        raise ValueError("Method must be 'remove', 'winsorize', 'log', or 'robust_scale'")

    return df_result

# Feature-specific outlier handling
def handle_outliers_by_feature(df):
    """
    Apply different treatment to different columns based on their characteristics
    """
    df_result = df.copy()

    # Amount-related columns (apply winsorization)
    amount_cols = ['oldbalanceOrg', 'newbalanceDest']
    for col in amount_cols:
        lower = df[col].quantile(0.005)
        upper = df[col].quantile(0.995)
        df_result[col] = np.clip(df[col], lower, upper)

    # Add outlier flags as features (instead of removing them)
    for col in amount_cols:
        z_scores = np.abs(stats.zscore(df[col]))
        df_result[f'{col}_is_outlier'] = (z_scores > 3).astype(int)

return df_result# X Data
X = df.drop(['isFraud'], axis=1)
print('X shape is : ', X.shape)
print()
y = df['isFraud']
print('y shape is : ', y.shape)
# Implement improved preprocessing pipeline
def preprocess_data(X, y):
"""
Improved preprocessing pipeline for fraud detection that preserves
outlier information while limiting extreme values
"""
# Create a copy to avoid modifying originals
X_processed = X.copy()
# Add outlier indicator features for important columns
numeric_cols = X.select_dtypes(include=np.number).columns
# Add outlier indicators for financial columns
financial_cols = ['oldbalanceOrg', 'newbalanceDest']
for col in financial_cols:
if col in X.columns:
z_scores = np.abs(stats.zscore(X[col]))
X_processed[f'{col}_outlier'] = (z_scores > 3).astype(int)
# Winsorize only the extreme outliers in amount columns (99.5% percentile)
for col in financial_cols:
if col in X.columns:
lower = X[col].quantile(0.005)
upper = X[col].quantile(0.995)
X_processed[col] = np.clip(X[col], lower, upper)
print(f"Preprocessing complete: Added {len(financial_cols)} outlier indicator features")
print(f"Original shape: {X.shape}, New shape: {X_processed.shape}")
return X_processed, y
# Apply the improved preprocessing
X_processed, y_processed = preprocess_data(X, y)
# Split the processed data
X_train, X_test, y_train, y_test = train_test_split(
X_processed, y_processed, test_size=0.3, random_state=42, shuffle=True
)
# Splitted Data
print('X_train shape is ', X_train.shape)
print('X_test shape is ', X_test.shape)
print('y_train shape is ', y_train.shape)
print('y_test shape is ', y_test.shape)
# print(len(y_train[y_train==0]) / len(y_train[y_train==1]))
# class_weights = {0: 1, 1: 50}
class_weights = {0: 1, 1: len(y_train[y_train==0]) / len(y_train[y_train==1])}
Out
X shape is :  (6362620, 7)

y shape is :  (6362620,)
Preprocessing complete: Added 2 outlier indicator features
Original shape: (6362620, 7), New shape: (6362620, 9)
X_train shape is  (4453834, 9)
X_test shape is  (1908786, 9)
y_train shape is  (4453834,)
y_test shape is  (1908786,)
# 4. Model Training
print("\nTraining CatBoost model...")
start_time = time.time()  # Start timer (add this line if you haven't defined start_time)

catboost_model = CatBoostClassifier(
    iterations=1000,           # Number of trees
    learning_rate=0.01,       # Learning rate
    depth=6,                  # Depth of trees
    l2_leaf_reg=3,           # L2 regularization coefficient
    loss_function='Logloss',  # Loss function
    eval_metric='AUC',        # Evaluation metric
    random_seed=42,           # Random seed for reproducibility
    class_weights=class_weights,  # Class weights for imbalanced data
    verbose=100,              # Print progress every 100 iterations
    early_stopping_rounds=50, # Early stopping rounds
    use_best_model=True,     # Use best model found during training
    task_type='CPU'          # Can change to 'GPU' if available
)

# Create eval set for early stopping
eval_set = [(X_test, y_test)]

# Train the model
catboost_model.fit(
    X_train,
    y_train,
    eval_set=eval_set,
    plot=True  # Plot training progress
)

training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training CatBoost model...
MetricVisualizer(layout=Layout(align_self='stretch', height='500px'))
0:	test: 0.9988206	best: 0.9988206 (0)	total: 345ms	remaining: 5m 44s
Stopped by overfitting detector  (50 iterations wait)

bestTest = 0.9995611658
bestIteration = 12

Shrink model to first 13 iterations.
Training completed in 12.54 seconds
# 5. Model Evaluation
# Evaluate on training data
y_train_pred = catboost_model.predict(X_train)
y_train_pred_proba = catboost_model.predict_proba(X_train)[:, 1]

# Evaluate on test data
y_pred_cat = catboost_model.predict(X_test)
y_pred_proba_cat = catboost_model.predict_proba(X_test)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
    'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_cat) * 100,
    'Precision': precision_score(y_test, y_pred_cat) * 100,
    'Recall': recall_score(y_test, y_pred_cat) * 100,
    'F1 Score': f1_score(y_test, y_pred_cat) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_cat) * 100,
    'PR AUC': average_precision_score(y_test, y_pred_proba_cat) * 100
}
Out
Predictions completed in 19.61 seconds
print("\n---------- CatBoost Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_cat))

print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")
Out
---------- CatBoost Model Evaluation ----------

Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       1.00      1.00      1.00      2435

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99952850% 99.99947611%  0.00005239%
Precision    100.00000000% 100.00000000%  0.00000000%
Recall       99.63655244% 99.58932238%  0.04723006%
F1 Score     99.81794538% 99.79423868%  0.02370670%
ROC AUC      99.96100614% 99.95611658%  0.00488957%
PR AUC       99.65746450% 99.59523736%  0.06222714%

Overfitting Score: 0.02301764%
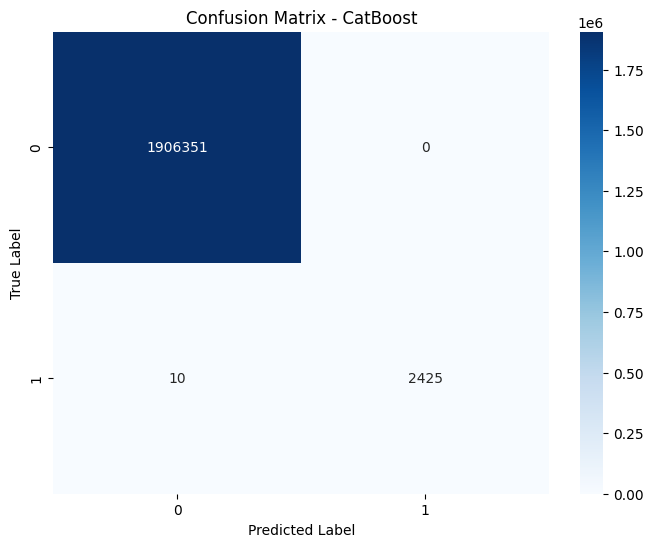
Model shows good generalization (score < 2%)# 6. Visualization
# Confusion Matrix
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_cat)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - CatBoost')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()
Out
# 4. Performance Tracking
start_time = time.time()

# 5. Feature Scaling - KNN is distance-based so scaling is essential
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 6. Class Distribution Analysis
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
print(f"Training data: {non_fraud_samples} non-fraud, {fraud_samples} fraud")
print(f"Class distribution ratio (non-fraud:fraud): {non_fraud_samples / fraud_samples:.2f}:1")

# 7. KNN Model Training with Optimizations for Imbalanced Data
print("\nTraining k-Nearest Neighbors model...")
knn_outlier_model = KNeighborsClassifier(
    n_neighbors=5,          # Start with a small number of neighbors as fraud cases are rare
    weights='distance',     # Weight points by inverse of their distance - better for imbalanced data
    algorithm='auto',       # Automatically choose the best algorithm
    leaf_size=30,           # Leaf size passed to BallTree or KDTree
    p=2,                    # Power parameter for the Minkowski metric (2 = Euclidean distance)
    metric='minkowski',     # Distance metric to use
    n_jobs=-1               # Use all available cores
)

knn_outlier_model.fit(X_train_scaled, y_train)
training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training data: 4448056 non-fraud, 5778 fraud
Class distribution ratio (non-fraud:fraud): 769.83:1

Training k-Nearest Neighbors model...
Training completed in 3.10 seconds
# 8. Model Evaluation
# Evaluate on training data
y_train_pred = knn_outlier_model.predict(X_train_scaled)
y_train_pred_proba = knn_outlier_model.predict_proba(X_train_scaled)[:, 1]

# Evaluate on test data
y_pred_knn = knn_outlier_model.predict(X_test_scaled)
y_pred_proba_knn = knn_outlier_model.predict_proba(X_test_scaled)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

print("\n---------- k-Nearest Neighbors (with Outlier Detection) Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_knn))

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_knn) * 100,
    'Precision': precision_score(y_test, y_pred_knn) * 100,
    'Recall': recall_score(y_test, y_pred_knn) * 100,
    'F1 Score': f1_score(y_test, y_pred_knn) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_knn) * 100
}
Out
Predictions completed in 15257.49 seconds

---------- k-Nearest Neighbors (with Outlier Detection) Model Evaluation ----------

Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       1.00      1.00      1.00      2435

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg 1.00 1.00 1.00 1908786print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
diff = train_metrics[metric] - test_metrics[metric]
print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")
# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
print("Model shows good generalization (score < 2%)")
else:
print("Model shows moderate overfitting")
# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
print(f'➤➤➤ {metric}: {value:.8f} %')Out
---------- Training vs Test Performance (Overfitting Analysis) ---------- Metric Training Test Difference -------------------------------------------------- Accuracy 99.99995509% 99.99916177% 0.00079332% Precision 100.00000000% 99.75318799% 0.24681201% Recall 99.96538595% 99.58932238% 0.37606356% F1 Score 99.98268998% 99.67118783% 0.31150214% ROC AUC 99.99999999% 99.79462915% 0.20537085% Overfitting Score: 0.22810838% Model shows good generalization (score < 2%) ---------- Detailed Test Metrics ---------- ➤➤➤ Accuracy: 99.99916177 % ➤➤➤ Precision: 99.75318799 % ➤➤➤ Recall: 99.58932238 % ➤➤➤ F1 Score: 99.67118783 % ➤➤➤ ROC AUC: 99.79462915 %
# 6. Visualization
# Confusion Matrix
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_knn)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - KNN (Do outlier handling)')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()
Out
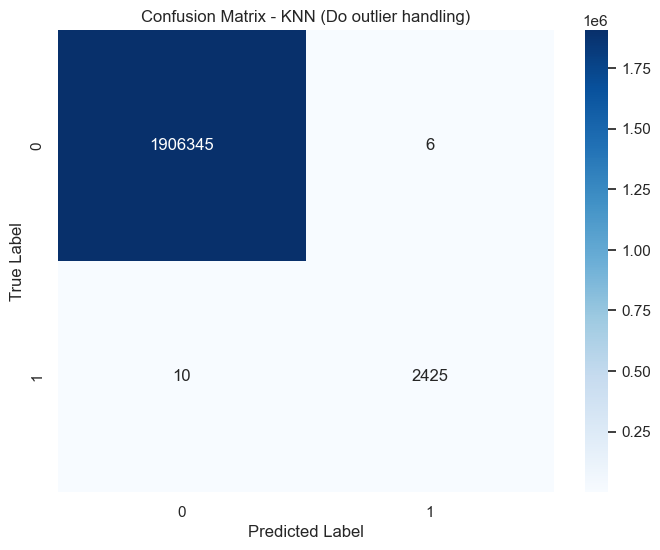
# 1. Performance Tracking
start_time = time.time()
# 2. Feature Scaling - very important for Logistic Regression
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
# 3. Class Weight Calculation
fraud_samples = sum(y_train == 1)
non_fraud_samples = sum(y_train == 0)
print(f"Training data: {non_fraud_samples} non-fraud, {fraud_samples} fraud")
print(f"Class distribution ratio (non-fraud:fraud): {non_fraud_samples / fraud_samples:.2f}:1")
# Define different class weight options
weight_options = {
'balanced': 'balanced',
'inverse': {
0: 1.0,
1: non_fraud_samples / fraud_samples
},
'sqrt': {
0: 1.0,
1: np.sqrt(non_fraud_samples / fraud_samples)
},
'custom': {
0: 1.0,
1: 2 * (non_fraud_samples / fraud_samples)
}
}
# Select weight approach
selected_weight = weight_options['inverse'] # Choose from: 'balanced', 'inverse', 'sqrt', 'custom'
print(f"\nSelected weight approach: {selected_weight}")
# 4. Model Training
print("\nTraining Logistic Regression model...")
lr_outlier_model = LogisticRegression(
penalty='l2', # L2 regularization to prevent overfitting
C=1.0, # Inverse of regularization strength
class_weight=selected_weight, # Handle class imbalance
solver='liblinear', # Efficient solver for small datasets
max_iter=1000, # Maximum iterations for convergence
verbose=1, # Output training progress
n_jobs=-1, # Use all available cores
random_state=42 # For reproducibility
)
lr_outlier_model.fit(X_train_scaled, y_train)
training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training data: 4448056 non-fraud, 5778 fraud
Class distribution ratio (non-fraud:fraud): 769.83:1
Selected weight approach: {0: 1.0, 1: 769.8262374524056}
Training Logistic Regression model...
[LibLinear]iter 1 act 2.465e+06 pre 2.175e+06 delta 8.073e-02 f 6.166e+06 |g| 6.218e+07 CG 1
cg reaches trust region boundary
iter 2 act 5.250e+05 pre 4.472e+05 delta 1.307e-01 f 3.701e+06 |g| 1.502e+07 CG 2
cg reaches trust region boundary
iter 3 act 3.816e+05 pre 3.446e+05 delta 3.195e-01 f 3.176e+06 |g| 5.506e+06 CG 2
cg reaches trust region boundary
iter 4 act 6.105e+05 pre 5.368e+05 delta 8.932e-01 f 2.794e+06 |g| 2.527e+06 CG 2
cg reaches trust region boundary
iter 5 act 1.096e+06 pre 1.048e+06 delta 1.723e+00 f 2.184e+06 |g| 1.656e+06 CG 1
iter 6 act 6.523e+05 pre 5.291e+05 delta 1.723e+00 f 1.088e+06 |g| 8.602e+05 CG 2
iter 7 act 2.073e+05 pre 1.638e+05 delta 1.723e+00 f 4.360e+05 |g| 2.912e+05 CG 4
iter 8 act 7.953e+04 pre 6.246e+04 delta 1.723e+00 f 2.288e+05 |g| 1.069e+05 CG 5
iter 9 act 3.269e+04 pre 2.553e+04 delta 1.863e+00 f 1.492e+05 |g| 4.004e+04 CG 5
iter 10 act 1.455e+04 pre 1.131e+04 delta 2.195e+00 f 1.165e+05 |g| 1.521e+04 CG 5
iter 11 act 7.106e+03 pre 5.598e+03 delta 2.713e+00 f 1.020e+05 |g| 5.992e+03 CG 7
iter 12 act 2.529e+03 pre 2.031e+03 delta 2.713e+00 f 9.489e+04 |g| 2.575e+03 CG 7
iter 13 act 8.527e+02 pre 6.763e+02 delta 2.713e+00 f 9.236e+04 |g| 1.591e+03 CG 6
iter 14 act 3.126e+02 pre 2.470e+02 delta 2.713e+00 f 9.151e+04 |g| 7.918e+02 CG 7
iter 15 act 1.280e+02 pre 9.909e+01 delta 2.713e+00 f 9.120e+04 |g| 3.016e+02 CG 8
iter 16 act 5.906e+01 pre 4.808e+01 delta 2.713e+00 f 9.107e+04 |g| 1.086e+02 CG 8
iter 17 act 8.855e+00 pre 8.263e+00 delta 2.713e+00 f 9.101e+04 |g| 4.133e+01 CG 7
iter 18 act 1.635e-01 pre 1.572e-01 delta 2.713e+00 f 9.100e+04 |g| 1.201e+01 CG 8
Training completed in 7.70 seconds# 5. Model Evaluation
# Evaluate on training data
y_train_pred = lr_outlier_model.predict(X_train_scaled)
y_train_pred_proba = lr_outlier_model.predict_proba(X_train_scaled)[:, 1]
# Evaluate on test data
y_pred_lr = lr_outlier_model.predict(X_test_scaled)
y_pred_proba_lr = lr_outlier_model.predict_proba(X_test_scaled)[:, 1]
prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")
print("\n---------- Logistic Regression (with Outlier Handling) Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_lr))
# Calculate metrics for both training and test sets
train_metrics = {
'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
'Precision': precision_score(y_train, y_train_pred) * 100,
'Recall': recall_score(y_train, y_train_pred) * 100,
'F1 Score': f1_score(y_train, y_train_pred) * 100,
'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}
test_metrics = {
'Accuracy': accuracy_score(y_test, y_pred_lr) * 100,
'Precision': precision_score(y_test, y_pred_lr) * 100,
'Recall': recall_score(y_test, y_pred_lr) * 100,
'F1 Score': f1_score(y_test, y_pred_lr) * 100,
'ROC AUC': roc_auc_score(y_test, y_pred_proba_lr) * 100,
'PR AUC': average_precision_score(y_test, y_pred_proba_lr) * 100
}
print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")

# Display individual metrics with arrows for visual emphasis
print("\n---------- Detailed Test Metrics ----------")
for metric, value in test_metrics.items():
    print(f'➤➤➤ {metric}: {value:.8f} %')
Out
Predictions completed in 6.78 seconds

---------- Logistic Regression (with Outlier Handling) Model Evaluation ----------

Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906351
           1       1.00      1.00      1.00      2435

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99916926% 99.99905699%  0.00011226%
Precision    99.72284774% 99.67118783%  0.05165991%
Recall       99.63655244% 99.58932238%  0.04723006%
F1 Score     99.67968141% 99.63023829%  0.04944312%
ROC AUC      99.95202126% 99.96174846% -0.00972720%
PR AUC       99.65536377% 99.59652943%  0.05883434%

Overfitting Score: 0.03292541%
Model shows good generalization (score < 2%)

---------- Detailed Test Metrics ----------
➤➤➤ Accuracy: 99.99905699 %
➤➤➤ Precision: 99.67118783 %
➤➤➤ Recall: 99.58932238 %
➤➤➤ F1 Score: 99.63023829 %
➤➤➤ ROC AUC: 99.96174846 %
➤➤➤ PR AUC: 99.59652943 %# 6. Visualization
# Confusion Matrix
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_lr)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - Logistic Regression (Do outlier handling)')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
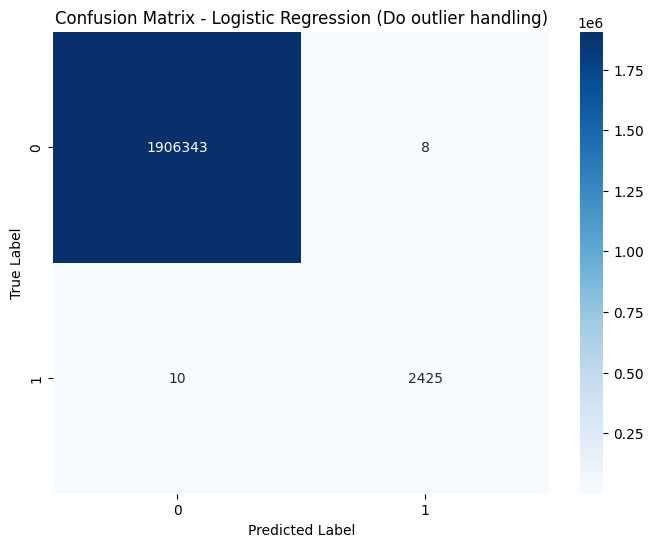
# X Data
X = df.drop(['isFraud'], axis=1)
print('X shape is : ', X.shape)
print()
y = df['isFraud']
print('y shape is : ', y.shape)

# Implement improved preprocessing pipeline
def preprocess_data(X, y):
    """
    Improved preprocessing pipeline for fraud detection that preserves
    outlier information while limiting extreme values
    """
    # Create a copy to avoid modifying originals
    X_processed = X.copy()

    # Add outlier indicator features for important columns
    numeric_cols = X.select_dtypes(include=np.number).columns

    # Add outlier indicators for financial columns
    financial_cols = ['oldbalanceOrg', 'newbalanceDest']
    for col in financial_cols:
        if col in X.columns:
            z_scores = np.abs(stats.zscore(X[col]))
            X_processed[f'{col}_outlier'] = (z_scores > 3).astype(int)

    # Winsorize only the extreme outliers in amount columns (99.5% percentile)
    for col in financial_cols:
        if col in X.columns:
            lower = X[col].quantile(0.005)
            upper = X[col].quantile(0.995)
            X_processed[col] = np.clip(X[col], lower, upper)

    print(f"Preprocessing complete: Added {len(financial_cols)} outlier indicator features")
    print(f"Original shape: {X.shape}, New shape: {X_processed.shape}")

    return X_processed, y

# Apply the improved preprocessing
X_processed, y_processed = preprocess_data(X, y)

# Split the processed data
X_train, X_test, y_train, y_test = train_test_split(
    X_processed, y_processed, test_size=0.3, random_state=42, shuffle=True, stratify=y_processed
)

# Print initial class distribution
print("\nOriginal class distribution in training set:")
print(pd.Series(y_train).value_counts(normalize=True) * 100)

# Apply Random Under-Sampling to balance classes
# You can adjust the sampling_strategy for different levels of undersampling
rus = RandomUnderSampler(sampling_strategy=0.5, random_state=42)  # 1:2 ratio of minority:majority
X_train_rus, y_train_rus = rus.fit_resample(X_train, y_train)

# Print balanced class distribution
print("\nBalanced class distribution after RUS:")
print(pd.Series(y_train_rus).value_counts(normalize=True) * 100)
print(f"Original training samples: {X_train.shape[0]}")
print(f"After RUS: {X_train_rus.shape[0]}")
Out
X shape is :  (6362620, 7)

y shape is :  (6362620,)
Preprocessing complete: Added 2 outlier indicator features
Original shape: (6362620, 7), New shape: (6362620, 9)

Original class distribution in training set:
isFraud
0    99.87092
1     0.12908
Name: proportion, dtype: float64

Balanced class distribution after RUS:
isFraud
0    66.666667
1    33.333333
Name: proportion, dtype: float64
Original training samples: 4453834
After RUS: 17247
# 4. Model Training with XGBoost
print("\nTraining XGBoost model on RUS-balanced data...")
start_time = time.time()  # Start timer

xgb_model = xgb.XGBClassifier(
    learning_rate=0.01,         # Learning rate
    n_estimators=200,           # Number of trees
    max_depth=6,                # Maximum tree depth
    min_child_weight=1,         # Minimum child weight
    gamma=0,                    # Minimum loss reduction for split
    subsample=0.8,              # Subsample ratio of training instances
    colsample_bytree=0.8,       # Subsample ratio of columns
    objective='binary:logistic', # Objective function
    scale_pos_weight=1,         # No need for additional weighting since data is balanced
    random_state=42             # Random seed
)

# Train the model on the balanced dataset
xgb_model.fit(
    X_train_rus,
    y_train_rus,
    eval_set=[(X_test, y_test)],
    verbose=100
)

training_time = time.time() - start_time
print(f"Training completed in {training_time:.2f} seconds")
Out
Training XGBoost model on RUS-balanced data...
[0]	validation_0-logloss:0.41013
[100]	validation_0-logloss:0.13930
[199]	validation_0-logloss:0.05416
Training completed in 8.26 seconds
# 5. Model Evaluation
# Evaluate on training data (original unbalanced set)
y_train_pred = xgb_model.predict(X_train)
y_train_pred_proba = xgb_model.predict_proba(X_train)[:, 1]

# Evaluate on test data
y_pred_xgb = xgb_model.predict(X_test)
y_pred_proba_xgb = xgb_model.predict_proba(X_test)[:, 1]

prediction_time = time.time() - start_time - training_time
print(f"Predictions completed in {prediction_time:.2f} seconds")

# Calculate metrics for both training and test sets
train_metrics = {
    'Accuracy': accuracy_score(y_train, y_train_pred) * 100,
    'Precision': precision_score(y_train, y_train_pred) * 100,
    'Recall': recall_score(y_train, y_train_pred) * 100,
    'F1 Score': f1_score(y_train, y_train_pred) * 100,
    'ROC AUC': roc_auc_score(y_train, y_train_pred_proba) * 100,
    'PR AUC': average_precision_score(y_train, y_train_pred_proba) * 100
}

test_metrics = {
    'Accuracy': accuracy_score(y_test, y_pred_xgb) * 100,
    'Precision': precision_score(y_test, y_pred_xgb) * 100,
    'Recall': recall_score(y_test, y_pred_xgb) * 100,
    'F1 Score': f1_score(y_test, y_pred_xgb) * 100,
    'ROC AUC': roc_auc_score(y_test, y_pred_proba_xgb) * 100,
    'PR AUC': average_precision_score(y_test, y_pred_proba_xgb) * 100
}

print("\n---------- RUS+XGBoost Model Evaluation ----------")
print("\nClassification Report (Test Set):")
print(classification_report(y_test, y_pred_xgb))

print("\n---------- Training vs Test Performance (Overfitting Analysis) ----------")
print(f"{'Metric':<12} {'Training':>12} {'Test':>12} {'Difference':>12}")
print("-" * 50)
for metric in train_metrics.keys():
    diff = train_metrics[metric] - test_metrics[metric]
    print(f"{metric:<12} {train_metrics[metric]:>11.8f}% {test_metrics[metric]:>11.8f}% {diff:>11.8f}%")

# Calculate overall overfitting score (average difference across metrics)
overfitting_score = np.mean([train_metrics[m] - test_metrics[m] for m in train_metrics.keys()])
print(f"\nOverfitting Score: {overfitting_score:.8f}%")
if overfitting_score > 5:
    print("WARNING: Model shows signs of overfitting (score > 5%)")
elif overfitting_score < 2:
    print("Model shows good generalization (score < 2%)")
else:
    print("Model shows moderate overfitting")
Out
Predictions completed in 20.00 seconds

---------- RUS+XGBoost Model Evaluation ----------

Classification Report (Test Set):
              precision    recall  f1-score   support

           0       1.00      1.00      1.00   1906322
           1       1.00      1.00      1.00      2464

    accuracy                           1.00   1908786
   macro avg       1.00      1.00      1.00   1908786
weighted avg       1.00      1.00      1.00   1908786


---------- Training vs Test Performance (Overfitting Analysis) ----------
Metric           Training         Test   Difference
--------------------------------------------------
Accuracy     99.99946114% 99.99931894%  0.00014220%
Precision    99.96508989% 99.83733225%  0.12775764%
Recall       99.61732475% 99.63474026% -0.01741551%
F1 Score     99.79090434% 99.73593337%  0.05497096%
ROC AUC      99.88084184% 99.88009483%  0.00074701%
PR AUC       99.62010658% 99.63627372% -0.01616714%

Overfitting Score: 0.02500586%
Model shows good generalization (score < 2%)# 6. Visualization
# Confusion Matrix
plt.figure(figsize=(8, 6))
cm = confusion_matrix(y_test, y_pred_xgb)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('Confusion Matrix - RUS+XGBoost')
plt.ylabel('True Label')
plt.xlabel('Predicted Label')
plt.show()Out
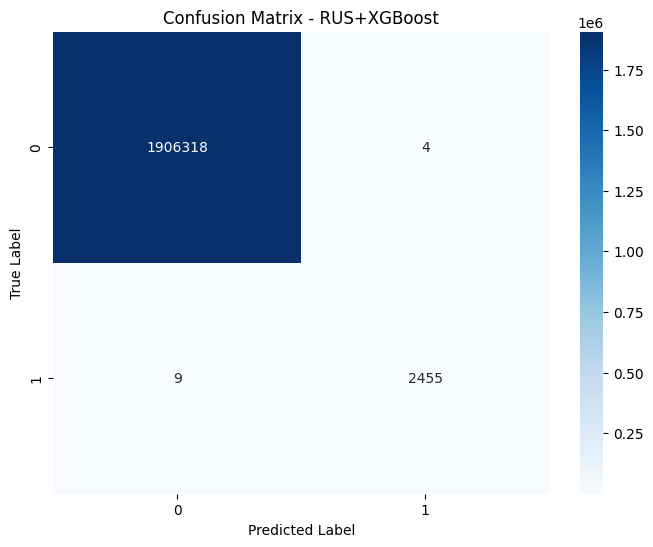
# warnings.filterwarnings('ignore')

# def evaluate_model(model, X_test_scaled, y_test, model_name, threshold=0.5):
#     """Evaluate a model using various metrics"""
#     start_time = time.time()

#     # Get predictions (handle different model types)
#     try:
#         y_pred_proba = model.predict_proba(X_test_scaled)[:, 1]
#     except:
#         # For models that might not have predict_proba
#         y_pred_proba = model.predict(X_test_scaled)

#     y_pred = (y_pred_proba >= threshold).astype(int)

#     # Calculate metrics
#     accuracy = accuracy_score(y_test, y_pred)
#     precision = precision_score(y_test, y_pred)
#     recall = recall_score(y_test, y_pred)
#     f1 = f1_score(y_test, y_pred)
#     roc_auc = roc_auc_score(y_test, y_pred_proba)

#     # Calculate precision-recall AUC
#     precision_curve, recall_curve, _ = precision_recall_curve(y_test, y_pred_proba)
#     pr_auc = auc(recall_curve, precision_curve)

#     # Confusion matrix
#     cm = confusion_matrix(y_test, y_pred)

#     # Speed test
#     inference_time = time.time() - start_time

#     # Return all metrics in a dictionary
#     return {
#         'model_name': model_name,
#         'accuracy': accuracy,
#         'precision': precision,
#         'recall': recall,
#         'f1_score': f1,
#         'roc_auc': roc_auc,
#         'pr_auc': pr_auc,
#         'confusion_matrix': cm,
#         'inference_time': inference_time,
#         'y_pred': y_pred,
#         'y_pred_proba': y_pred_proba
#     }

# # Use the models you've already trained (these variables should be defined in your environment)
# # If any of these variables aren't defined, remove them from the dictionary
# models_in_memory = {
#     'XGBoost': {'model': xgb_model, 'threshold': 0.5},
#     'LightGBM': {'model': lgb_model, 'threshold': 0.5},
#     'Random Forest': {'model': rf_model, 'threshold': 0.5},
#     'Logistic Regression (weighted)': {'model': lr_model, 'threshold': 0.5},
#     'K-Nearest Neighbors': {'model': knn_model, 'threshold': 0.5},
# }

# # Remove any models that aren't actually defined in your environment
# models = {}
# for name, model_info in models_in_memory.items():
#     if 'model' in model_info and model_info['model'] is not None:
#         models[name] = model_info
#         print(f"Using {name} model from memory")

# # Evaluate all models
# results = []
# for name, model_info in models.items():
#     model = model_info['model']
#     threshold = model_info['threshold']
#     print(f"Evaluating {name} model...")

#     eval_results = evaluate_model(model, X_test_scaled, y_test, name, threshold)
#     results.append(eval_results)

#     print(f"  - Accuracy: {eval_results['accuracy']:.8f}")
#     print(f"  - Precision: {eval_results['precision']:.8f}")
#     print(f"  - Recall: {eval_results['recall']:.8f}")
#     print(f"  - F1 Score: {eval_results['f1_score']:.8f}")
#     print(f"  - ROC AUC: {eval_results['roc_auc']:.8f}")
#     print(f"  - PR AUC: {eval_results['pr_auc']:.8f}")
#     print(f"  - Inference time: {eval_results['inference_time']:.8f} seconds")
#     print()

# # Create DataFrame with all results
# results_df = pd.DataFrame([{
#     'Model': r['model_name'],
#     'Accuracy (%)': r['accuracy'] * 100,
#     'Precision (%)': r['precision'] * 100,
#     'Recall (%)': r['recall'] * 100,
#     'F1 Score (%)': r['f1_score'] * 100,
#     'ROC AUC (%)': r['roc_auc'] * 100,
#     'PR AUC (%)': r['pr_auc'] * 100,
#     'Inference Time (s)': r['inference_time']
# } for r in results])

# # Display table of all metrics
# print("\n==== Model Comparison ====")
# print(results_df.to_string(index=False, float_format=lambda x: f"{x:.8f}"))
# # Plot metrics comparison
# metrics_to_plot = ['Accuracy (%)', 'Precision (%)', 'Recall (%)',
#                     'F1 Score (%)', 'ROC AUC (%)', 'PR AUC (%)']

# plt.figure(figsize=(14, 10))
# for i, metric in enumerate(metrics_to_plot):
#     plt.subplot(2, 3, i+1)
#     sns.barplot(x='Model', y=metric, data=results_df)
#     plt.title(metric)
#     plt.xticks(rotation=45)
#     plt.ylim(0, 100)
# plt.tight_layout()
# plt.suptitle('Model Performance Comparison', fontsize=16)
# plt.subplots_adjust(top=0.9)
# plt.show()
# # Plot ROC curves for all models
# plt.figure(figsize=(10, 8))
# for r in results:
#     # Calculate ROC curve
#     fpr, tpr, _ = roc_curve(y_test, r['y_pred_proba'])
#     label = f"{r['model_name']} (AUC = {r['roc_auc']:.3f})"
#     plt.plot(fpr, tpr, label=label)

# plt.plot([0, 1], [0, 1], 'k--', label='Random')
# plt.xlabel('False Positive Rate')
# plt.ylabel('True Positive Rate')
# plt.title('ROC Curves for All Models')
# plt.legend()
# plt.grid(True, alpha=0.3)
# plt.show()
# # Plot Precision-Recall curves for all models
# plt.figure(figsize=(10, 8))
# for r in results:
#     # Calculate Precision-Recall curve
#     precision, recall, _ = precision_recall_curve(y_test, r['y_pred_proba'])
#     label = f"{r['model_name']} (AUC = {r['pr_auc']:.3f})"
#     plt.plot(recall, precision, label=label)

# # Add the random baseline
# no_skill = sum(y_test == 1) / len(y_test)
# plt.plot([0, 1], [no_skill, no_skill], 'k--', label='Random')
# plt.xlabel('Recall')
# plt.ylabel('Precision')
# plt.title('Precision-Recall Curves for All Models')
# plt.legend()
# plt.grid(True, alpha=0.3)
# plt.show()
# # Plot confusion matrices for each model
# num_models = len(results)
# fig, axes = plt.subplots(nrows=(num_models+1)//2, ncols=2, figsize=(15, 4*((num_models+1)//2)))
# axes = axes.flatten() if num_models > 1 else [axes]

# for i, r in enumerate(results):
#     if i < len(axes):
#         cm = r['confusion_matrix']
#         sns.heatmap(cm, annot=True, fmt='d', cmap='Blues', ax=axes[i])
#         axes[i].set_title(f'Confusion Matrix - {r["model_name"]}')
#         axes[i].set_ylabel('True Label')
#         axes[i].set_xlabel('Predicted Label')

# # Hide any unused subplots
# for j in range(i+1, len(axes)):
#     fig.delaxes(axes[j])

# plt.tight_layout()
# plt.show()
# # Calculate inference time comparison
# plt.figure(figsize=(10, 6))
# sns.barplot(x='Model', y='Inference Time (s)', data=results_df)
# plt.title('Model Inference Time Comparison')
# plt.xticks(rotation=45)
# plt.ylabel('Time (seconds)')
# plt.grid(True, alpha=0.3)
# plt.show()
# # Find the best model for each metric
# best_models = {}
# for metric in metrics_to_plot:
#     if 'Time' not in metric:
#         best_idx = results_df[metric].idxmax()
#         best_models[metric] = results_df.loc[best_idx, 'Model']
#     else:
#         best_idx = results_df[metric].idxmin()
#         best_models[metric] = results_df.loc[best_idx, 'Model']

# print("\n==== Best Models ====")
# for metric, model in best_models.items():
#     print(f"Best for {metric}: {model}")

# # Print the overall recommendation
# print("\n==== Recommendation ====")
# # Count how many times each model is the best
# model_counts = {}
# for model in best_models.values():
#     if model in model_counts:
#         model_counts[model] += 1
#     else:
#         model_counts[model] = 1

# # Find the model with the highest count
# best_overall = max(model_counts.items(), key=lambda x: x[1])[0]

# print(f"Overall recommended model: {best_overall}")
# print("This model achieves the best balance of performance metrics.")

# # If fraud detection is the priority, emphasize recall and F1
# print("\nFor fraud detection specifically:")
# print(f"Best model for recall (detecting frauds): {best_models['Recall (%)']}")
# print(f"Best model for F1 score (balance): {best_models['F1 Score (%)']}")
# print(f"Best model for PR AUC (overall ranking): {best_models['PR AUC (%)']}")

# # If interpretability is needed
# interpretable_models = ['Logistic Regression', 'Logistic Regression (weighted)']
# interpretable_present = [model for model in interpretable_models if model in models]
# if interpretable_present:
#     print("\nIf interpretability is required, consider:")
#     for model in interpretable_present:
#         print(f"- {model}")